Все
 Истории
 Дизайн
 Код
 Геймдев
 Бизнес
 Маркетинг
 Управление
 Кино
 Музыка
 Проектная фотография
 Развитие
 Деньги
 Здоровье
 Образование
 EdTech
 Корп. обучение
 Блог Skillbox
 Глоссарий
 Спецпроекты

Свёрточная нейронная сеть: что это и как она работает
Разбираемся в принципах свёртки и архитектуре CNN, создаём модель на Python.
Нейросети умеют распознавать лица на фотографиях, находить опухоли на медицинских снимках и определять дорожные знаки. Но как компьютер понимает, что именно изображено на картинке? Ведь для него любая фотография — это всего лишь массив чисел.
Одна из технологий, которые позволяют решать такие задачи, — свёрточные нейросети, или CNN. Они стали важным инструментом компьютерного зрения и используются в самых разных сферах — от медицины до градостроительства.
В этой статье мы расскажем, как устроены свёрточные нейросети, по каким принципам они работают и где применяются. А затем покажем, как создать простую CNN на Python.
Содержание
- Что такое свёрточная нейронная сеть
- Где применяют CNN
- Из каких слоёв состоит CNN
- Как работает операция свёртки
- Как обучается свёрточная нейросеть
- Пишем свёрточную нейросеть на Python
- Преимущества и ограничения CNN
- Что нужно запомнить
Что такое свёрточная нейронная сеть
Свёрточная нейронная сеть (convolutional neural network, CNN) — это разновидность нейросети, которая находит характерные признаки в данных. Например, при распознавании автомобиля на фотографии первые слои могут обнаруживать линии и контуры, а следующие — более сложные признаки, характерные для колёс и фар. На основе найденных признаков нейросеть определяет, что изображено на фотографии.
Чтобы понять, как работает CNN, сравним её с многослойным персептроном (multilayer perceptron, MLP). В полносвязных слоях персептрона каждый нейрон связан со всеми нейронами предыдущего слоя.
Представим цветное изображение размером 32×32 пикселя. У каждого пикселя есть три цветовых канала, поэтому изображение можно представить в виде 3072 чисел: 32×32×3.
Чтобы обработать такое изображение с помощью персептрона, все 3072 числа выстраивают в одну последовательность. Каждый нейрон первого полносвязного слоя получает все эти значения. Поэтому даже небольшой слой может содержать много параметров. Например, для слоя из десяти нейронов потребуется 30 720 весов и десять смещений — всего 30 730 параметров.
CNN использует другой подход. Вместо того чтобы обрабатывать всё изображение сразу, она анализирует небольшие участки с помощью фильтров. Каждый фильтр последовательно перемещается по изображению и использует один и тот же набор весов. Значения этих весов нейросеть настраивает самостоятельно во время обучения.
Например, для фильтра размером 3×3 пикселя, который обрабатывает цветное изображение, потребуется всего 27 весов: 3×3×3. Если в свёрточном слое десять таких фильтров, общее количество параметров составит 280: 270 весов и десять смещений. Для сравнения, в рассмотренном выше полносвязном слое персептрона их было 30 730, то есть почти в сто десять раз больше.
Это условное сравнение: полносвязный и свёрточный слои выполняют разные операции. Тем не менее оно показывает важную особенность CNN: одни и те же веса используются для поиска признаков в разных частях изображения. Благодаря этому свёрточные слои могут обходиться значительно меньшим количеством обучаемых параметров.
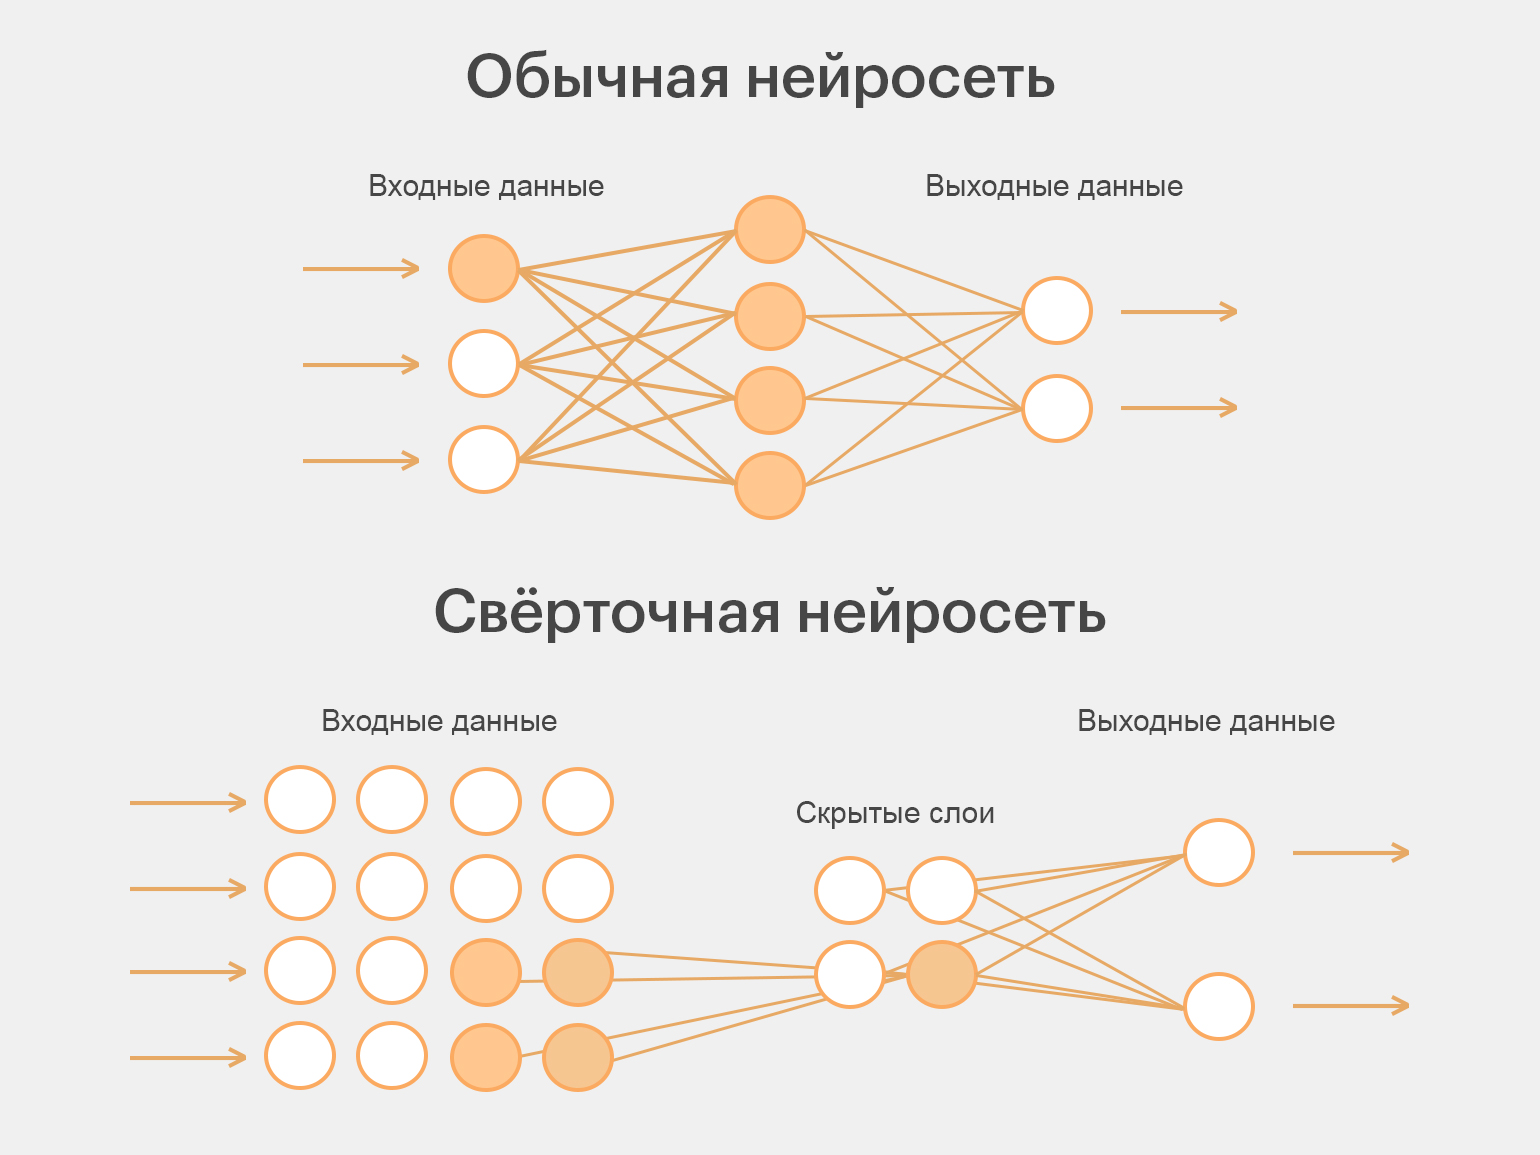
Иллюстрация: Skillbox Media
Где применяют CNN
Свёрточные нейронные сети используют не только для распознавания изображений, но и для анализа медицинских снимков, видео, звука и других данных. Рассмотрим несколько о примеров применения CNN.
Классификация изображений. CNN определяет, что изображено на фотографии. Например, нейросеть может распознать собаку, кошку или автомобиль. При этом обычный классификатор не указывает, где именно находится объект.
Обнаружение объектов. Нейросеть помогает не только распознавать объекты, но и определять их расположение на изображении. Например, системы контроля дорожного движения могут находить автомобили и номерные знаки, выделяя их прямоугольными рамками.
Сегментация изображений. Нейросеть анализирует изображение на уровне отдельных пикселей и определяет, к каким объектам они относятся. Например, она может выделить силуэт человека, отделив его от фона.
Медицина. CNN используют для анализа рентгеновских снимков, КТ и МРТ. Нейросети помогают находить подозрительные участки и признаки заболеваний. Например, архитектуру U-Net применяют для сегментации медицинских изображений. Такие системы помогают врачам анализировать снимки, но не заменяют медицинского заключения.
Распознавание текста (optical character recognition, OCR). Нейросеть могут использовать для распознавания букв и цифр на фотографиях и сканах документов. Например, такие технологии помогают преобразовывать отсканированные страницы книг в редактируемый текст.
Анализ видео. CNN используют для обнаружения объектов и распознавания действий в видеозаписях. Например, нейросеть может отслеживать движение автомобилей или людей. Для анализа последовательности кадров применяют в том числе трёхмерную свёртку (3D convolution), которая позволяет учитывать изменения изображения во времени.
Распознавание звука. Нейросети могут анализировать аудиозаписи, преобразованные в спектрограммы — изображения, которые показывают, как меняются частоты звука во времени. Это позволяет различать речь, лай собаки, шум двигателя и другие звуки.
Анализ временных рядов. CNN используют для обработки данных, которые поступают последовательно, например показаний датчиков на производстве. С помощью одномерной свёртки (1D convolution) нейросеть анализирует соседние значения и находит характерные закономерности. Это помогает, например, выявлять признаки неисправности оборудования.
Таким образом, CNN подходят для работы с разными типами данных. Главное, чтобы в них можно было находить характерные признаки и закономерности с помощью свёртки.
Из каких слоёв состоит CNN
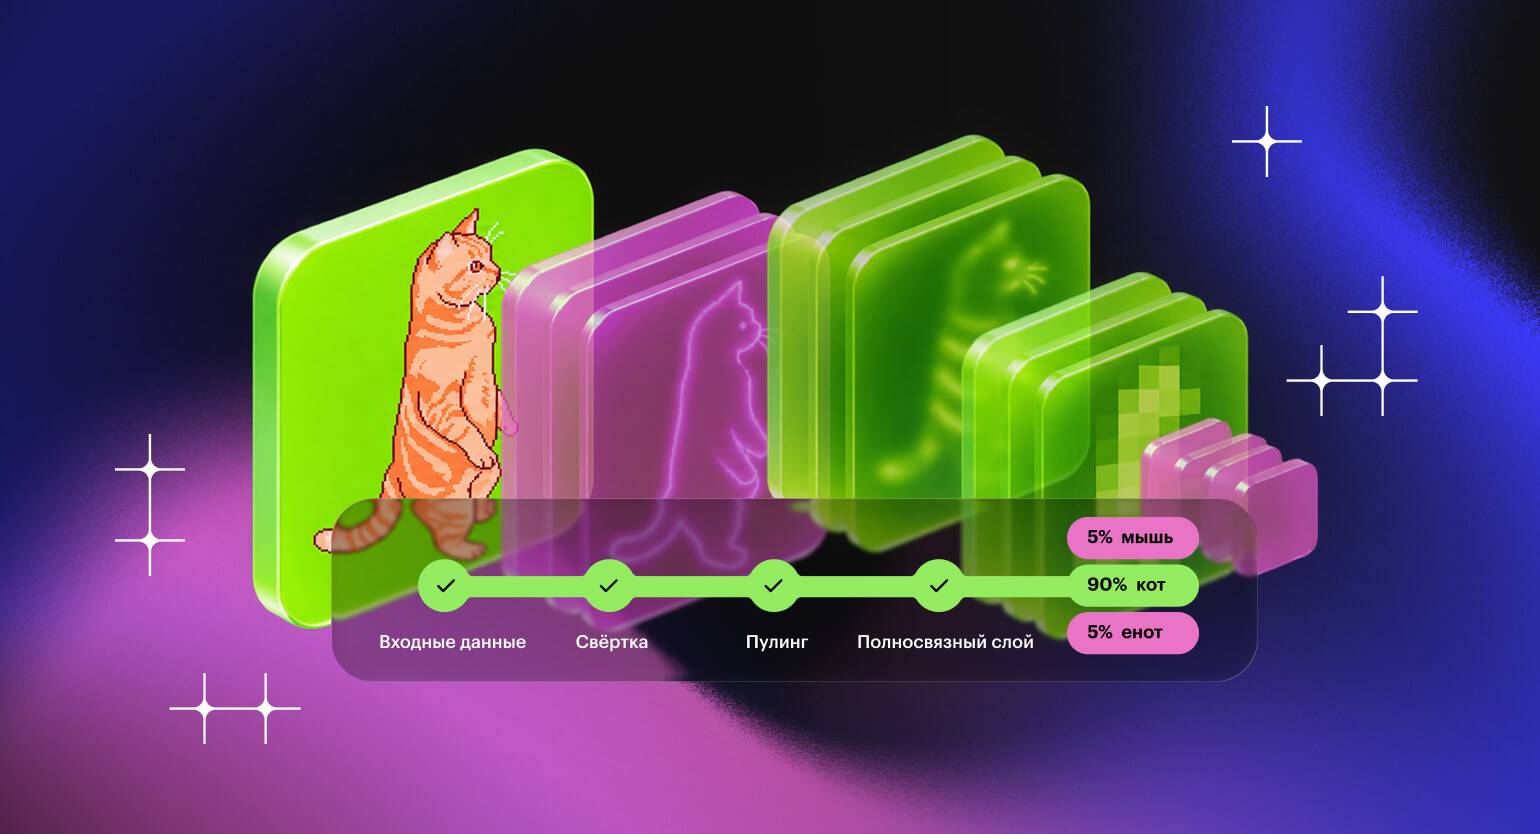
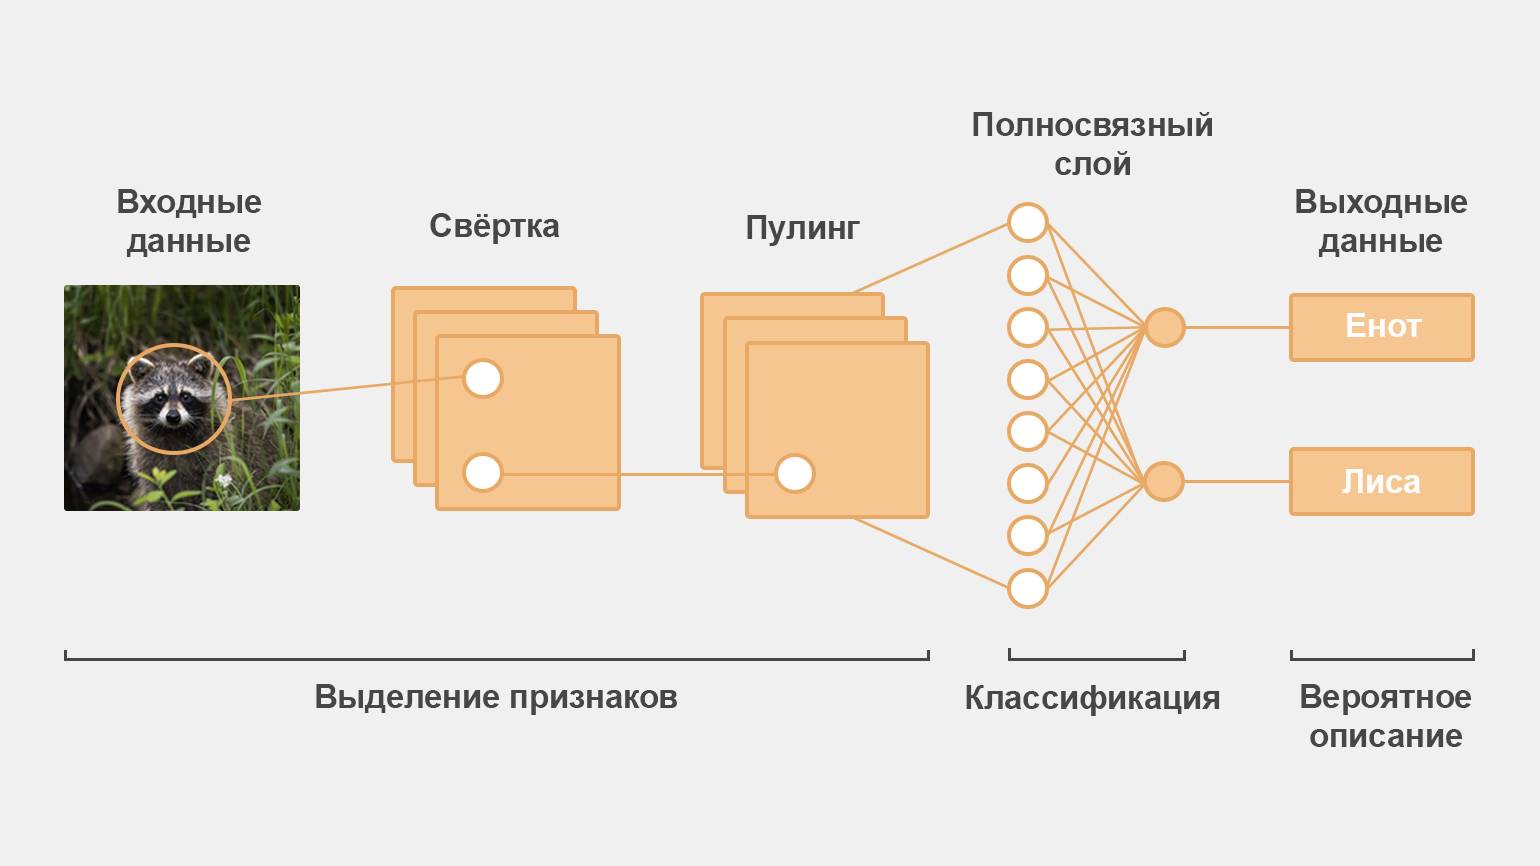
Свёрточная нейронная сеть обрабатывает изображение в несколько этапов. Сначала она выделяет характерные признаки, например линии, контуры и текстуры, а затем использует их для распознавания объекта. Рассмотрим этот процесс поэтапно.
Входные данные. Нейросеть получает изображение, представленное в виде массива чисел. Каждое число соответствует значению пикселя. Например, цветное изображение размером 32×32 пикселя содержит три цветовых канала — красный, зелёный и синий.
Свёртка. Нейросеть последовательно обрабатывает небольшие участки изображения с помощью фильтров. Каждый фильтр ищет определённые признаки, например вертикальные линии или границы объектов. В результате формируются карты признаков, которые показывают, где и насколько сильно проявляются найденные признаки.
Пулинг. Нейросеть уменьшает размер карт признаков, сохраняя наиболее важную информацию. Например, при максимальном пулинге из каждого небольшого участка выбирается наибольшее значение. Это позволяет сократить количество данных для дальнейшей обработки.
Полносвязный слой. Полученные признаки передаются в полносвязный слой. Здесь нейроны используют информацию из предыдущих слоёв, чтобы рассчитать оценки для возможных классов объектов. Например, нейросеть может оценивать, насколько изображение похоже на кошку или собаку.
Выходные данные. На последнем этапе нейросеть выдаёт результат классификации. Например, с помощью функции Softmax оценки можно преобразовать в вероятности: кошка — 90%, собака — 10%. Класс с наибольшей вероятностью выбирается в качестве ответа.
На схеме показан упрощённый принцип работы CNN. В реальных нейросетях свёрточные слои могут чередоваться с функциями активации и пулингом несколько раз. Это позволяет постепенно переходить от простых признаков к более сложным и точнее распознавать объекты.
Как работает операция свёртки
Во время свёртки фильтр проходит по изображению небольшими участками. В каждом положении он вычисляет значение, которое показывает отклик на определённый признак, например границу между светлыми и тёмными участками. Таким образом формируется карта признаков. Рассмотрим, как это происходит на примере.
Входной тензор — это массив чисел, в котором хранится информация об изображении. Так в 8-битном чёрно-белом изображении яркость каждого пикселя выражена числом от 0 до 255, где 0 — чёрный цвет, 255 — белый, а остальные — оттенки серого.
Чтобы нейросеть обучалась стабильнее, значения пикселей нормализуют, то есть приводят к диапазону от 0 до 1. В случае чёрно-белого изображения каждое число делят на 255. Например, значение 128 после деления на 255 становится чуть выше 0,5, но оттенок пикселя при этом не меняется.
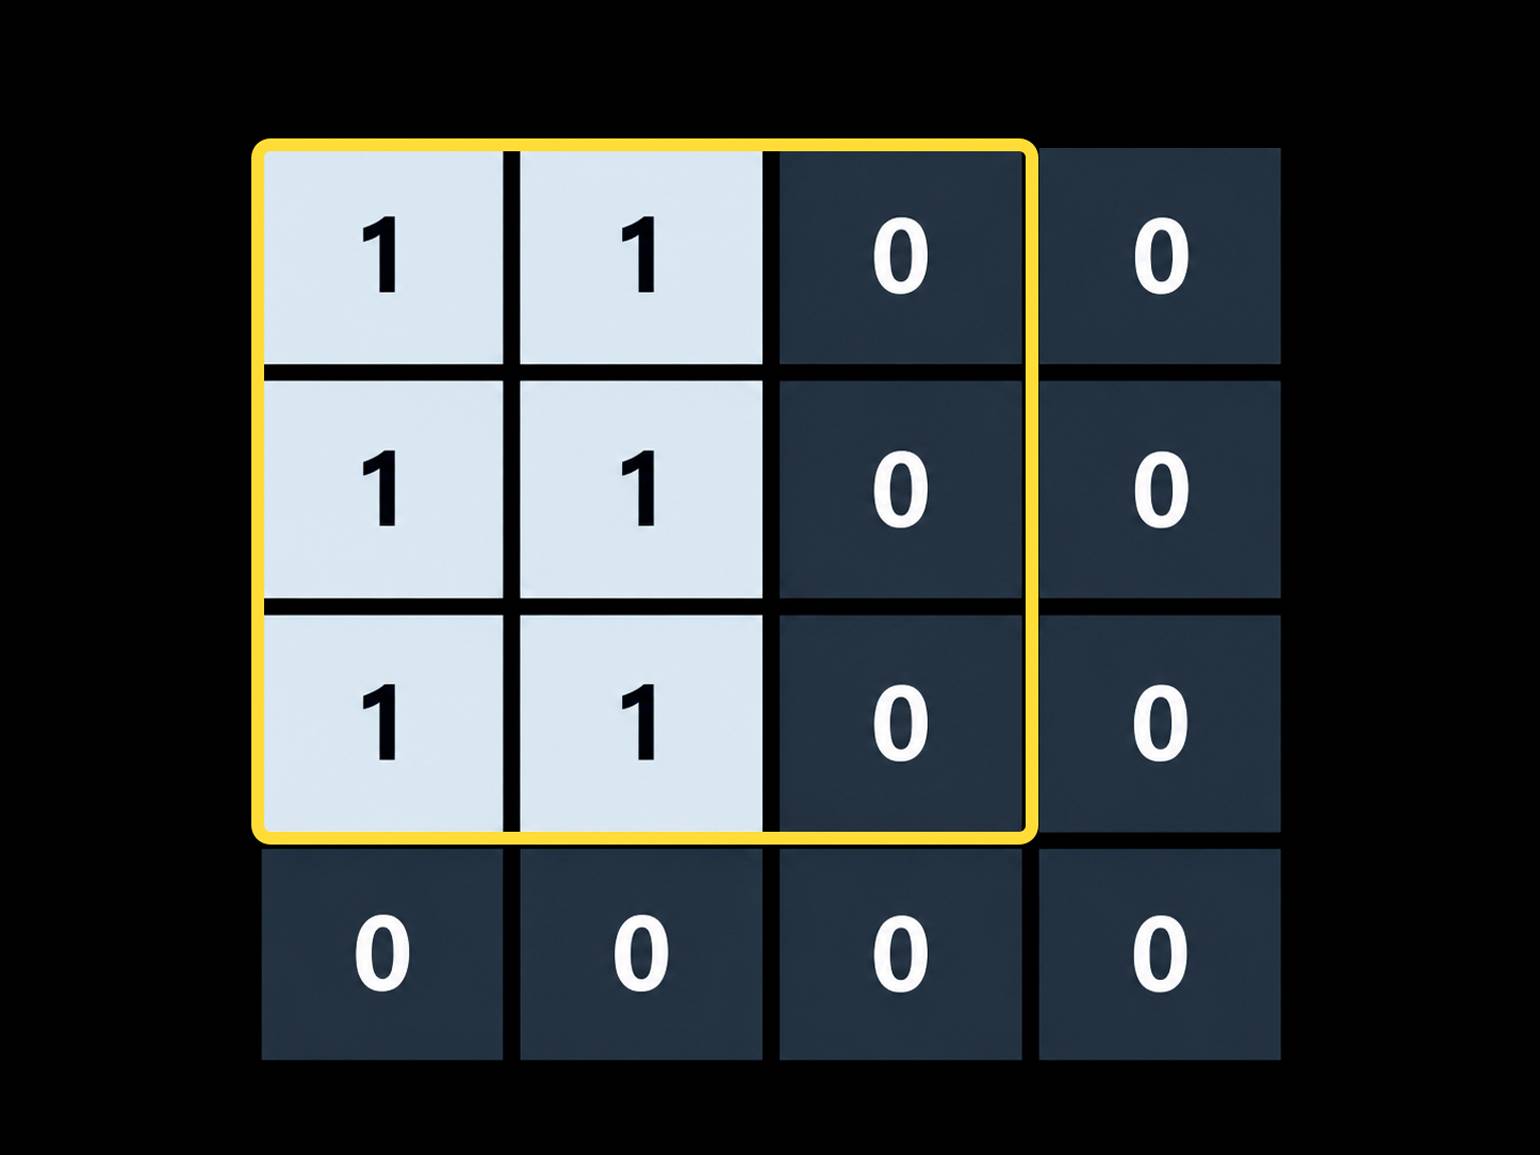
Возьмём пример с чёрно-белым изображением 4×4 пикселя. На схеме ниже единицы обозначают белые пиксели, а нули — чёрные.
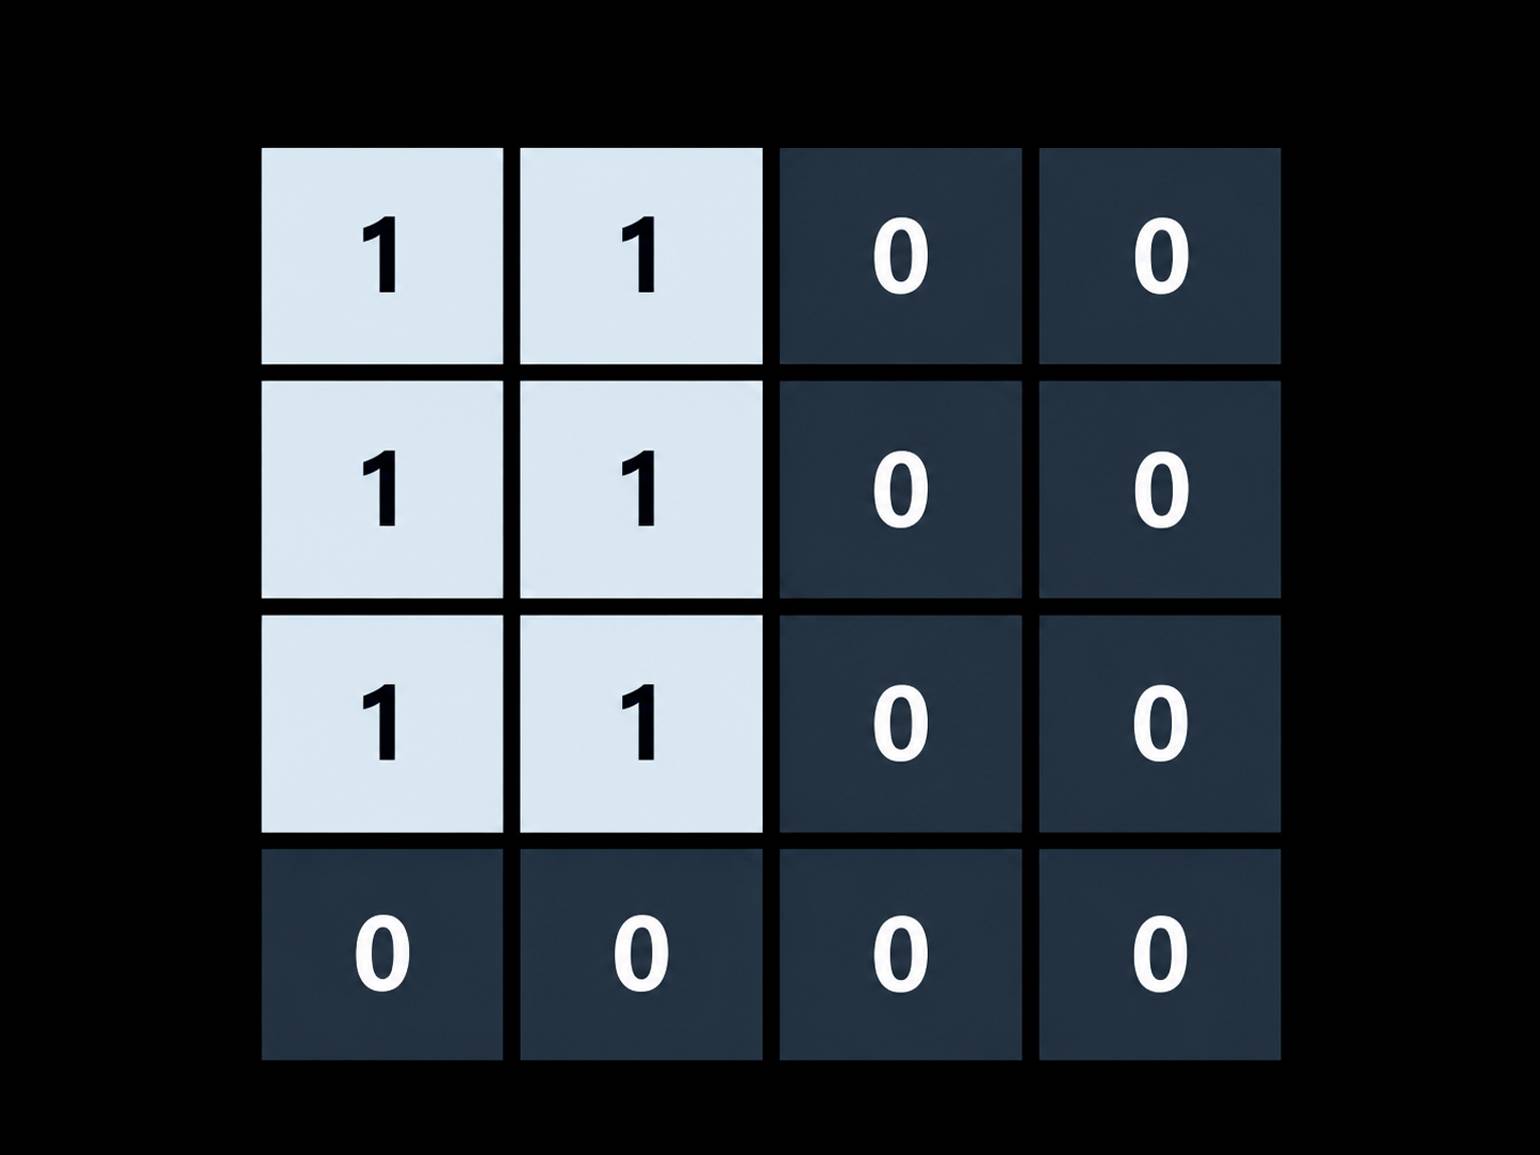
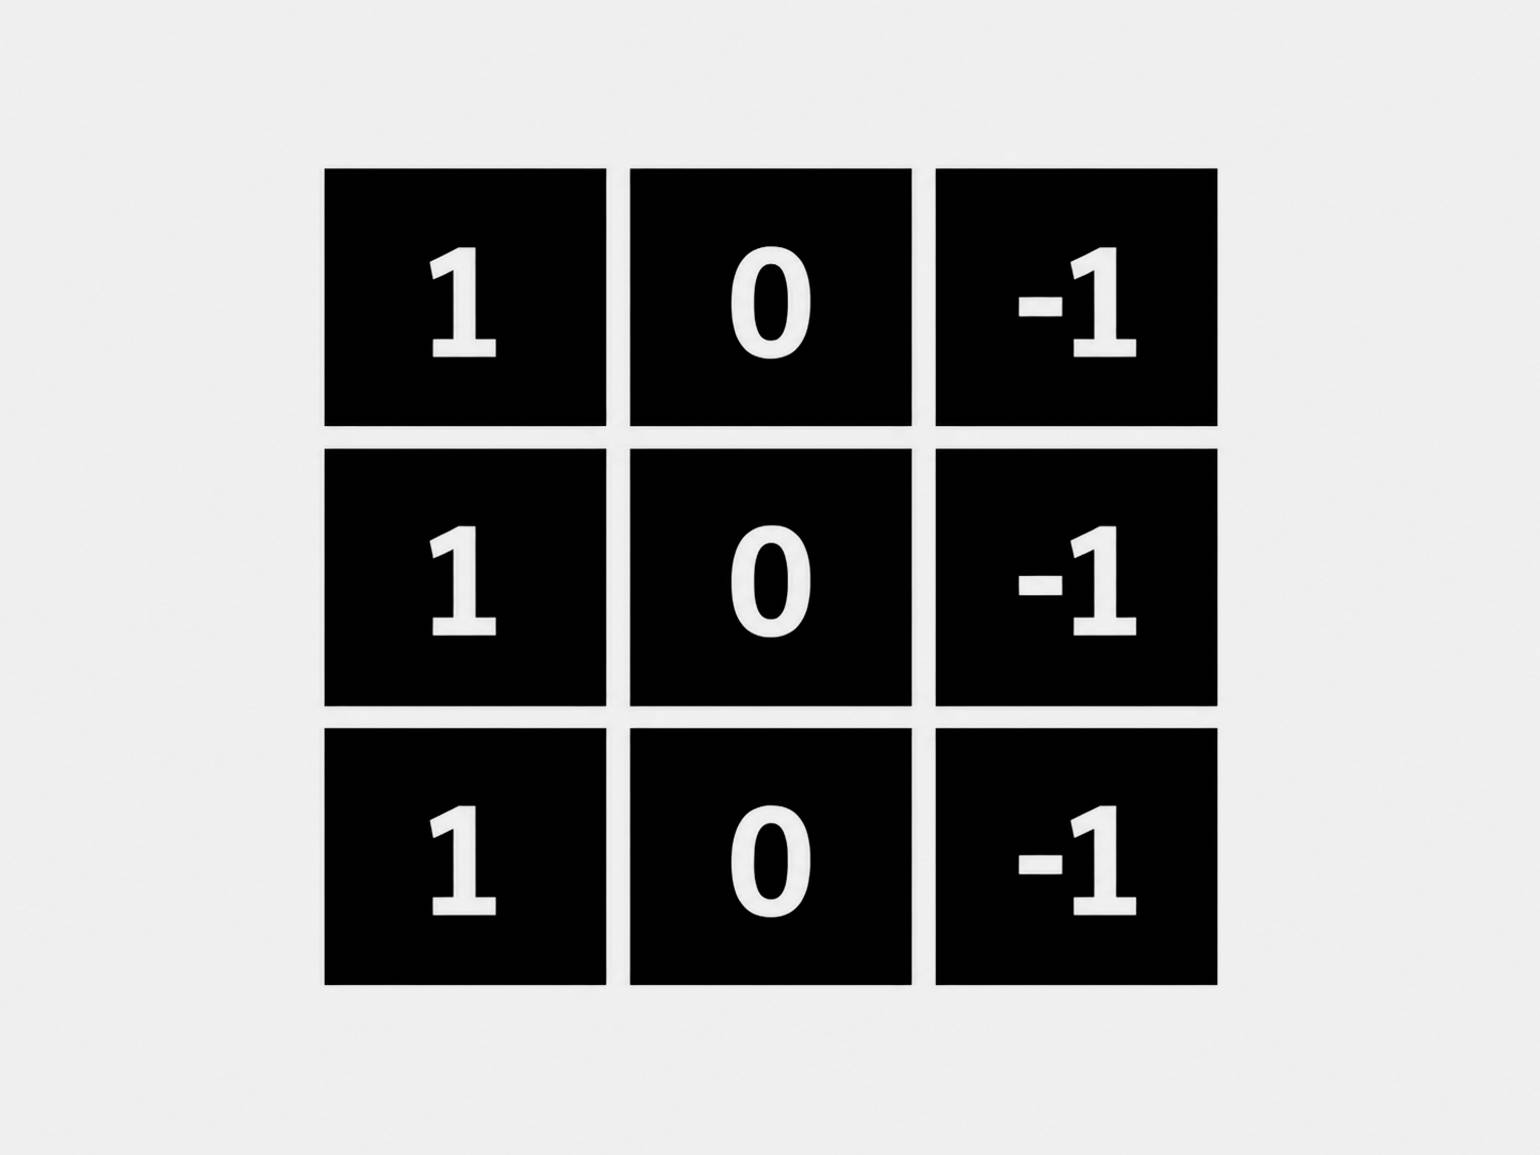
Теперь возьмём фильтр, или ядро свёртки, размером 3×3, с тремя строками. В каждой строке находятся веса 1, 0 и −1. Такое ядро сравнивает яркость левой и правой области изображения и реагирует на вертикальные границы. Текущий фильтр — всего лишь условный пример. В реальных свёрточных нейросетях значения весов подбирают непосредственно при обучении.
Изображение: ChatGPT / OpenAI / Skillbox Media
Попробуем наложить фильтр на левый верхний участок. Значение каждого пикселя умножаем на значение веса в той же позиции, а затем складываем полученные результаты. Так значение одной строки составит (1 × 1) + (1 × 0) + (0 × (−1)) = 1. В двух остальных строках результат такой же. Складываем три единицы и получаем 3.
Изображение: ChatGPT / OpenAI / Skillbox Media
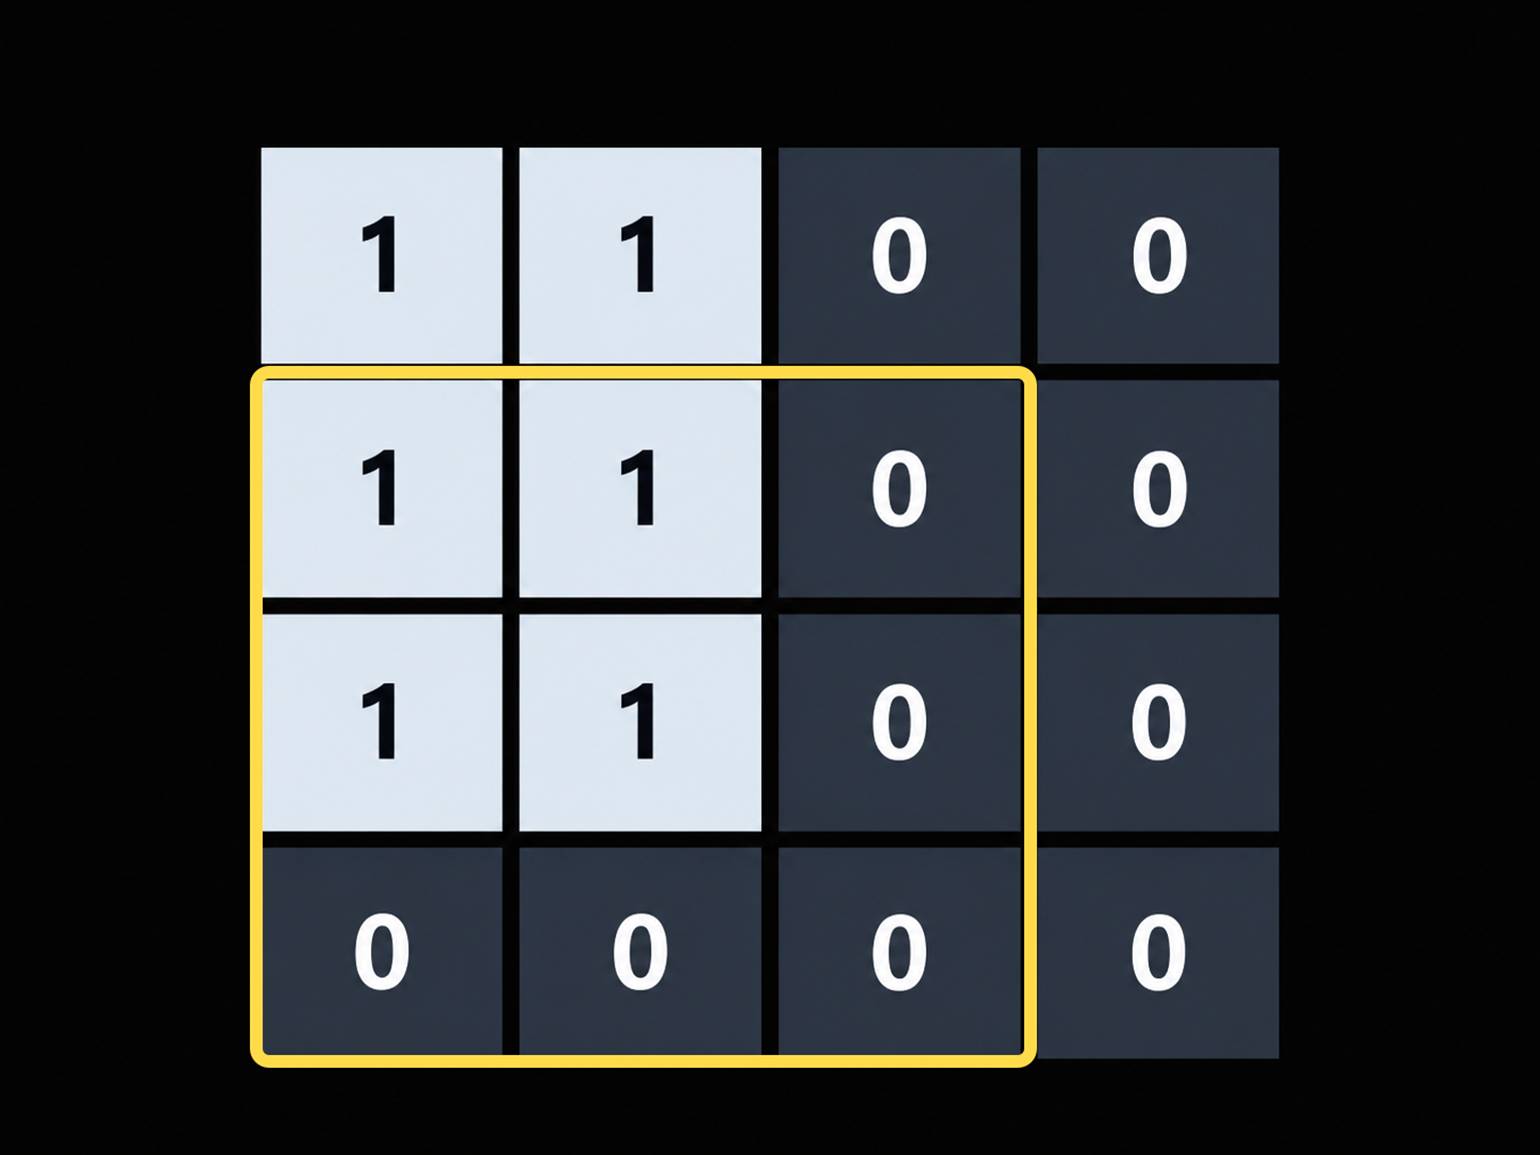
Если после этого мы сдвинем ядро свёртки на ячейку ниже и проведём аналогичные расчёты, получим значение 2.
Изображение: ChatGPT / OpenAI / Skillbox Media
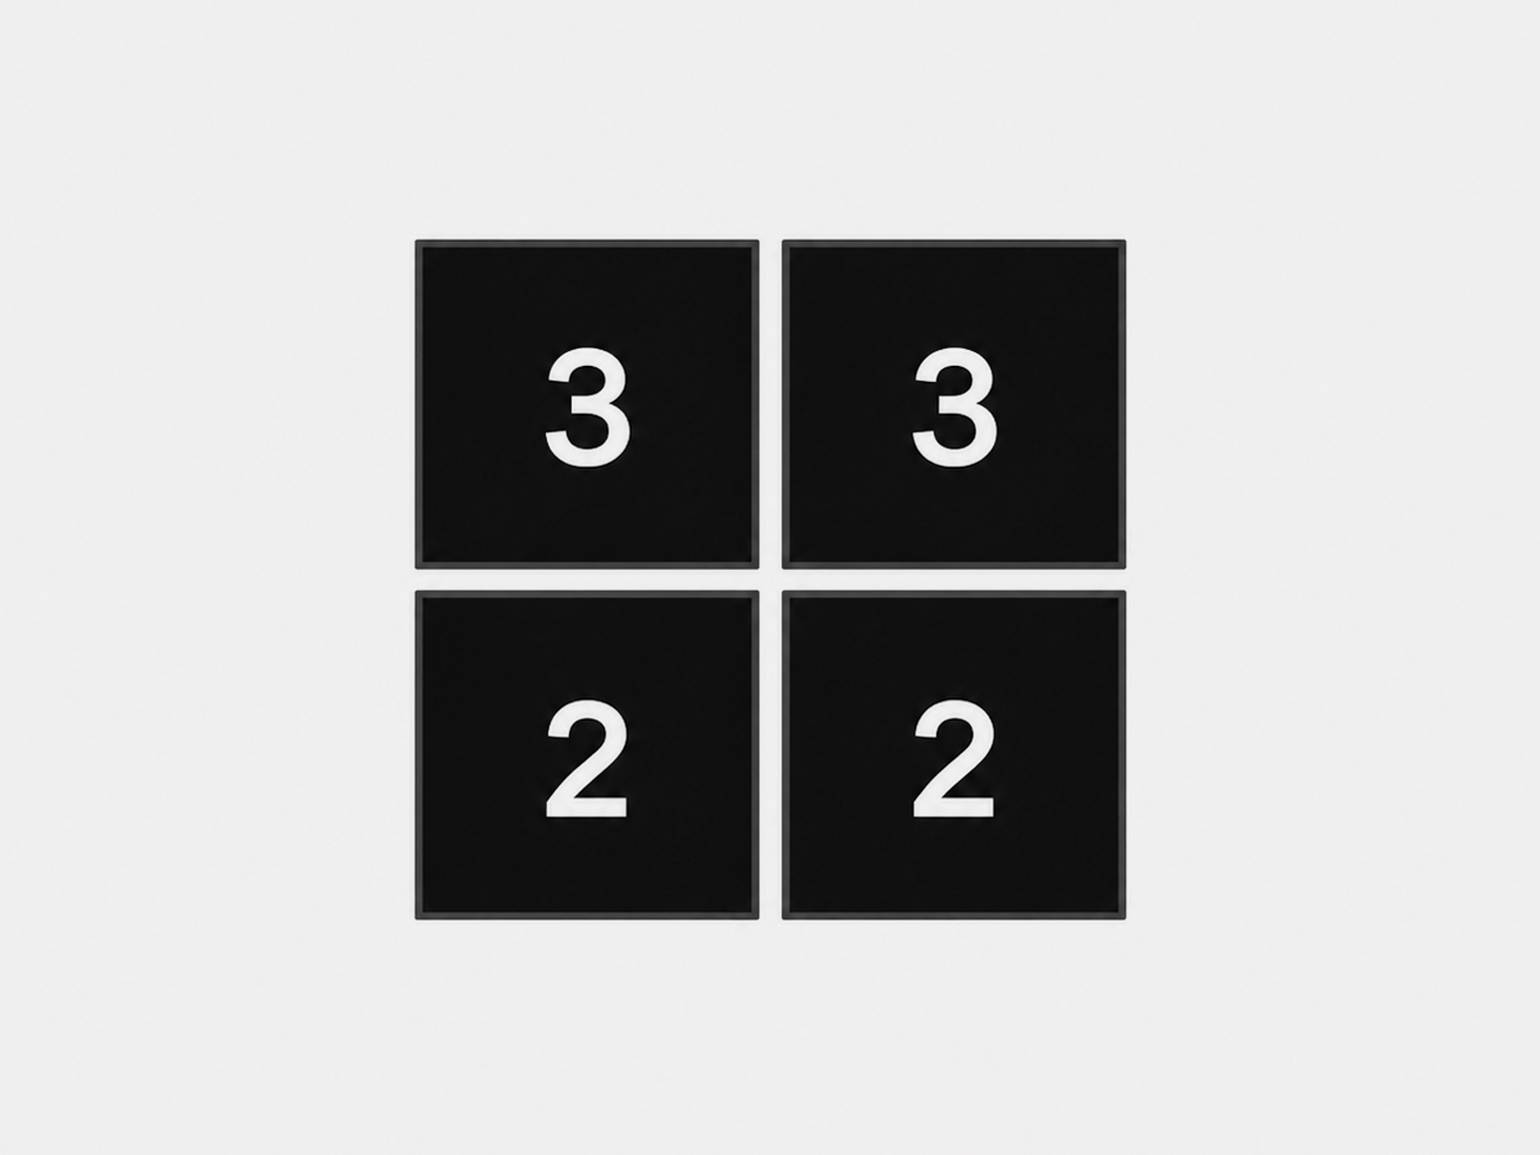
Затем переместим фильтр вправо и повторим вычисления для двух оставшихся участков. Получим ещё два значения — 3 для верхней части и 2 для нижней. В результате получилась карта признаков размером 2 на 2. Числа в ней отражают, насколько сильно ядро свёртки реагирует на перепад яркости слева направо. В текущем примере значение 3 даёт более сильный отклик, чем 2.
Изображение: ChatGPT / OpenAI / Skillbox Media
В результате один фильтр создаёт одну карту признаков, то есть один выходной канал. Если применить несколько фильтров с разными весами, каждый создаст собственную карту. Вместе такие фильтры образуют свёрточный слой (Convolutional layer).
Как обучается свёрточная нейросеть
Чтобы CNN научилась распознавать объекты, ей нужно показать множество изображений с известными правильными ответами. Во время обучения нейросеть сравнивает свои прогнозы с этими ответами и постепенно корректирует параметры.
Рассмотрим процесс на примере CNN, которая должна отличать кошек от собак.
Шаг 1: подготовка данных
Перед началом обучения должны быть собраны фотографии кошек и собак, для каждой из которых указан правильный класс. Эти изображения делят на три выборки:
- обучающая (training) — для настройки параметров нейросети;
- проверочная (validation) — для оценки качества модели во время разработки;
- тестовая (test) — для итоговой проверки.
Перед обучением изображения приводят к одинаковому размеру и нормализуют значения пикселей, например переводят их из диапазона 0–255 в диапазон 0–1.
Также может использоваться аугментация данных (data augmentation) — создание изменённых вариантов фотографий: с поворотом, отражением по осям или изменённой яркостью,. Это помогает CNN распознавать животных при разном освещении и положении в кадре.
Шаг 2: прямой проход (forward pass)
В начале обучения веса нейросети обычно задают случайным образом, поэтому она ещё не умеет отличать кошек от собак.
Изображения подают небольшими группами — мини-батчами (mini-batch). Каждая фотография проходит через свёрточные слои, которые выделяют признаки, а затем через классификатор, который определяет вероятность каждого класса.
Например, CNN получает фотографию кошки и выдаёт результат: кошка — 20%, собака — 80%. Нейросеть ошиблась, поскольку присвоила более высокую вероятность неправильному классу.
Шаг 3: расчёт ошибки
Чтобы оценить, насколько сильно ошиблась нейросеть, используют функцию потерь (loss function). Для классификации часто применяют перекрёстную энтропию (cross-entropy loss).
Она учитывает вероятность, которую CNN присвоила правильному классу. В нашем примере вероятность кошки составляет всего 20%, поэтому значение функции потерь будет высоким. Если бы нейросеть оценила её в 95%, потери были бы значительно ниже.
Обычно ошибку рассчитывают для всего мини-батча, а не для одной фотографии.
Шаг 4: обновление весов
После расчёта ошибки запускается обратное распространение (backpropagation). Алгоритм вычисляет, как каждый обучаемый параметр влияет на ошибку.
Затем оптимизатор, например стохастический градиентный спуск (SGD), обновляет веса и смещения нейросети, чтобы уменьшить ошибку. В результате CNN постепенно учится лучше выделять признаки, по которым можно отличить кошку от собаки.
Шаг 5: повторение обучения
После обновления весов CNN получает следующий мини-батч. Когда нейросеть обработает всю обучающую выборку, завершится одна эпоха (epoch). Обычно обучение продолжается несколько эпох, в течение которых модель многократно анализирует изображения и корректирует параметры.
После каждой эпохи качество CNN можно оценивать на проверочной выборке. Это помогает выявить переобучение (overfitting) — ситуацию, когда нейросеть хорошо распознаёт обучающие изображения, но часто ошибается на новых. Чтобы снизить риск переобучения, используют различные методы, например dropout, weight decay и раннюю остановку (early stopping).
После завершения обучения CNN проверяют на тестовой выборке — фотографиях, которые не использовались при обучении и настройке модели. Так оценивают, насколько хорошо нейросеть распознаёт новые изображения.
Пишем свёрточную нейросеть на Python
Создадим простую свёрточную нейросеть, которая будет распознавать рукописные цифры. Процесс будем выполнять в Google Colab — онлайн-среде, где можно запускать код Python прямо в браузере.
Для создания модели используем библиотеку для машинного обучения TensorFlow с модулем Keras, а для обучения — набор изображений рукописных цифр MNIST. Каждому изображению соответствует метка — число, обозначающее, какая цифра на нём написана. Суть задачи в том, чтобы обучить CNN определять, какая цифра от 0 до 9 изображена на картинке.
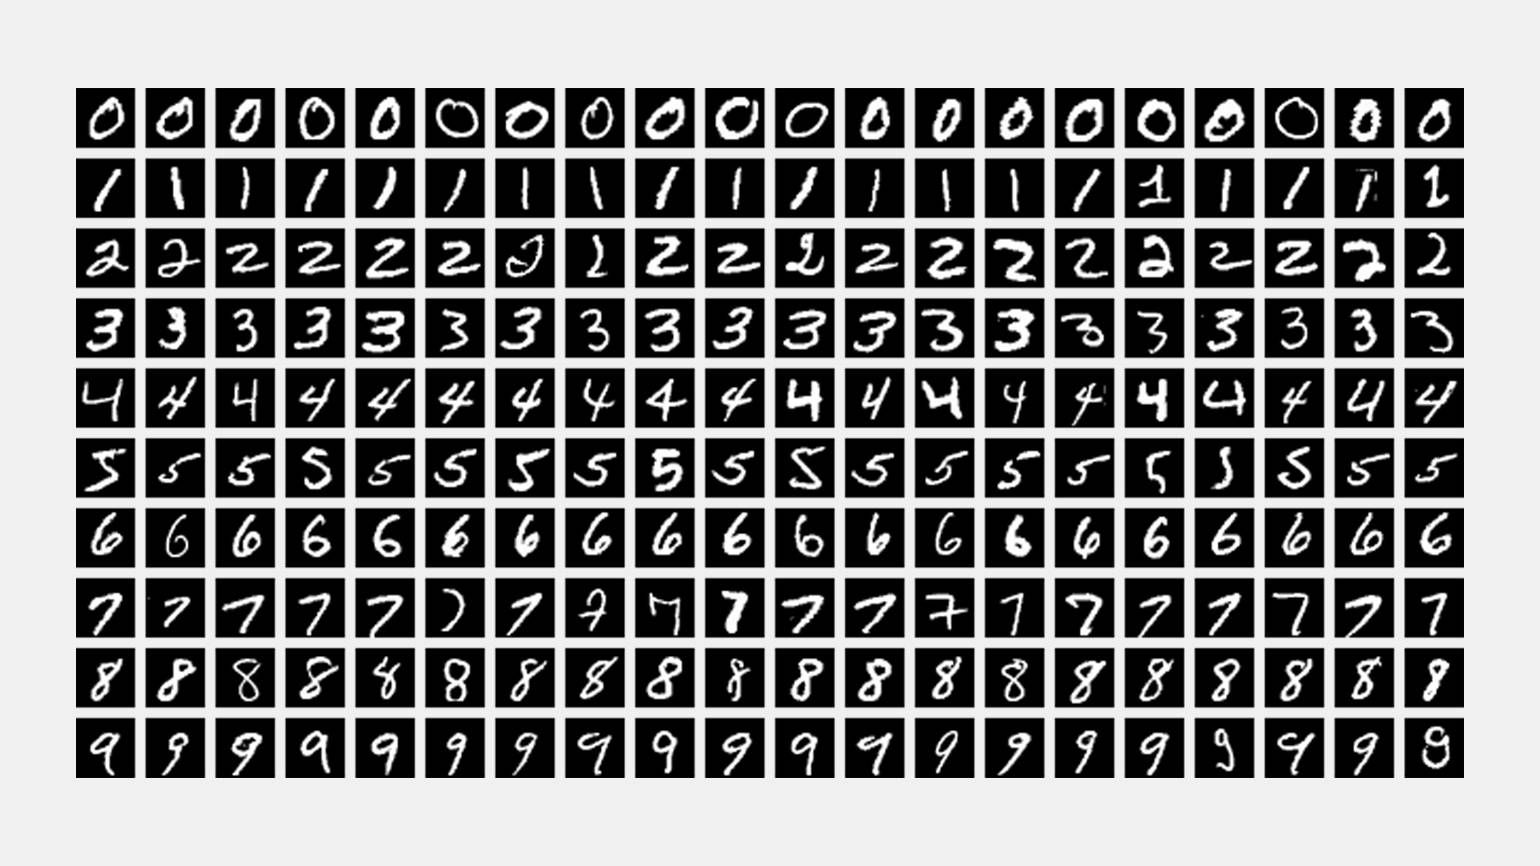
Изображение: Suvanjanprasai / Wikimedia Commons
Шаг 1: установите библиотеки в Google Colab
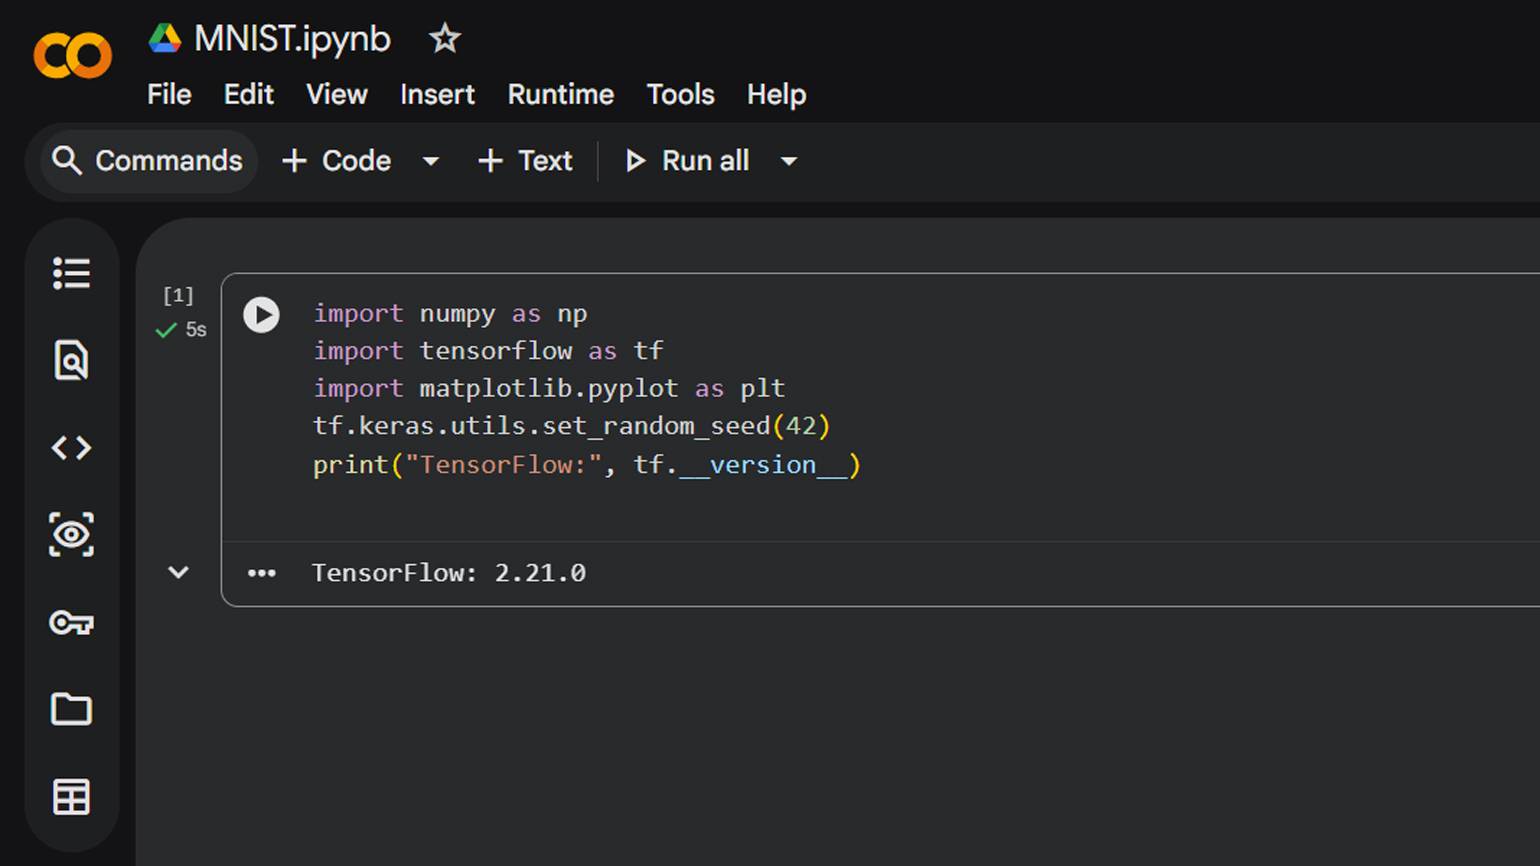
Зайдите в Google Colab и создайте новый блокнот, нажав кнопку +New Notebook. В первой ячейке подключите необходимые библиотеки: TensorFlow отвечает за работу нейросети, NumPy — за операции с числовыми массивами, Matplotlib понадобится для отображения цифр.
import numpy as np
import tensorflow as tf
import matplotlib.pyplot as plt
tf.keras.utils.set_random_seed(42)
print("TensorFlow:", tf.__version__)
Команда set_random_seed (42) фиксирует начальные настройки генераторов случайных чисел, чтобы результаты экспериментов было проще повторять. Число 42 выбрано произвольно, вместо него можно указать любое другое. И наконец, команда print выводит на экран установленную версию TensorFlow.
Скриншот: Google Colab / Google / Skillbox Media
Шаг 2: загрузите датасет
В следующей строке запустите код для загрузки датасета MNIST:
(x_train, y_train), (x_test, y_test) = tf.keras.datasets.mnist.load_data()
print("Обучающие изображения:", x_train.shape)
print("Обучающие метки:", y_train.shape)
print("Тестовые изображения:", x_test.shape)
print("Тестовые метки:", y_test.shape)
Разберём, как работает код. Метод tf.keras.datasets.mnist.load_data() загружает датасет MNIST и разделяет его на две части: обучающую и тестовую. Первая нужна для обучения нейросети, а вторая — для проверки того, насколько хорошо нейросеть распознаёт изображения, которые раньше не видела.
Загруженные данные сохраняются в четырёх переменных:
- x_train — изображения для обучения нейросети;
- y_train — правильные ответы для обучающих изображений, то есть цифры от 0 до 9;
- x_test — изображения для тестирования нейросети;
- y_test — правильные ответы для тестовых изображений.
С помощью команды print() выводим информацию о размерах полученных массивов. Атрибут .shape показывает количество элементов и их размерность.
В результате получим следующий вывод:
Обучающие изображения: (60000, 28, 28)
Обучающие метки: (60000,)
Тестовые изображения: (10000, 28, 28)
Тестовые метки: (10000,)
Разберём вывод на примере x_train. Значение (60000, 28, 28) означает, что массив содержит 60 000 изображений размером 28×28 пикселей. А значение (60000,) для y_train показывает, что каждому изображению соответствует одна метка с правильным ответом. Тестовый набор устроен аналогично, но содержит 10 000 изображений и меток.
Шаг 3: подготовьте данные
Перед обучением нейросети нужно подготовить изображения. Для этого выполним два действия: нормализуем значения пикселей и изменим форму массивов.
В MNIST яркость каждого пикселя представлена числом от 0 до 255, где 0 соответствует чёрному цвету, а 255 — белому. Чтобы привести значения к диапазону от 0 до 1, разделим их на 255. Такая нормализация помогает сделать обучение нейросети более стабильным.
Затем добавим ещё одно измерение — количество каналов изображения. В MNIST изображения представлены в оттенках серого, поэтому у каждого из них один канал. В результате форма отдельного изображения изменится с (28, 28) на (28, 28, 1).
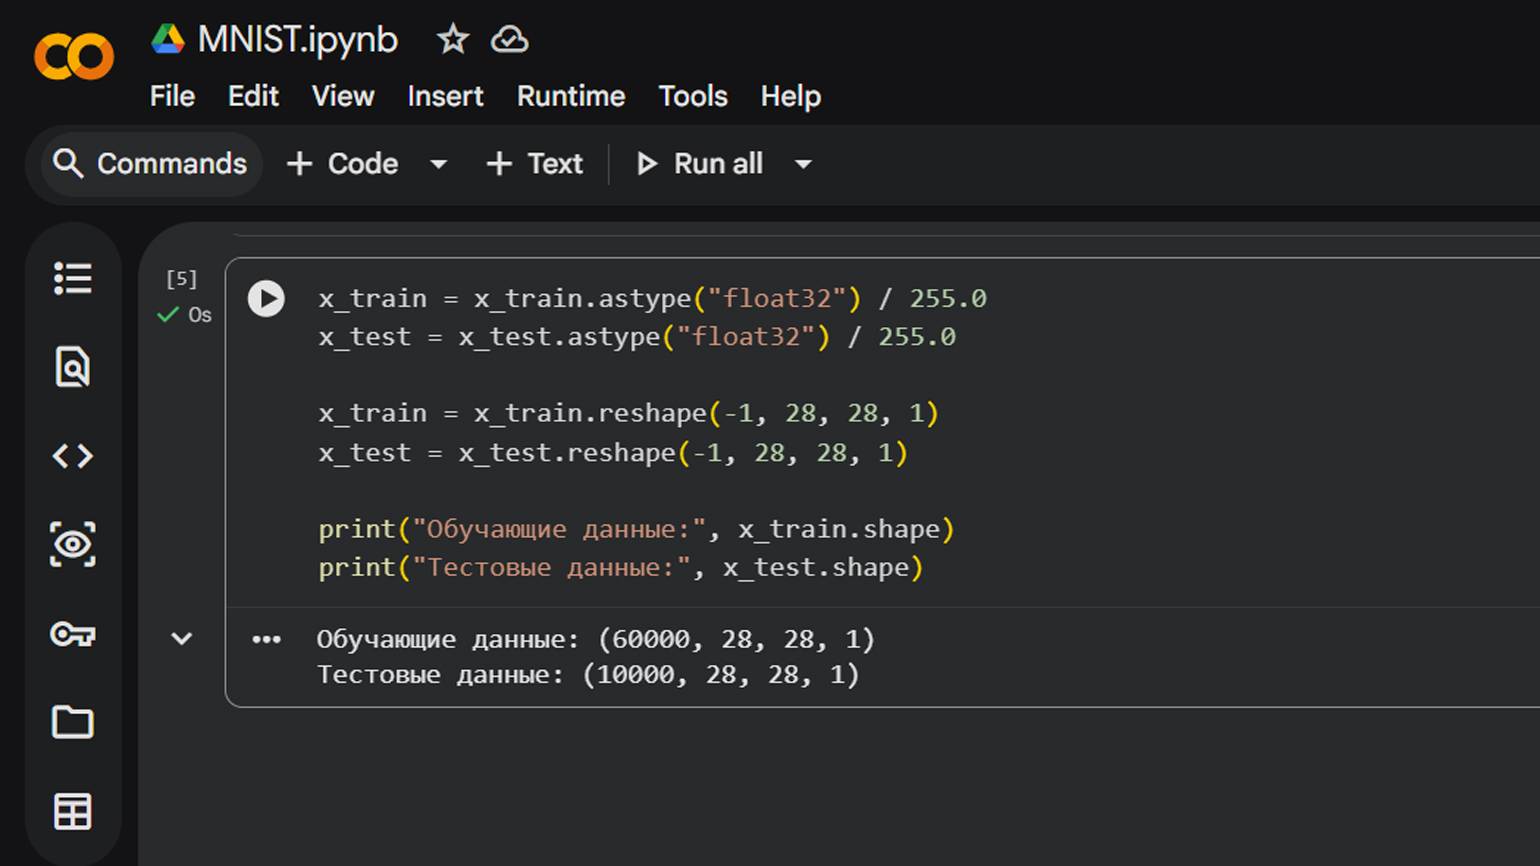
Выполните следующий код:
x_train = x_train.astype("float32") / 255.0
x_test = x_test.astype("float32") / 255.0
x_train = x_train.reshape(-1, 28, 28, 1)
x_test = x_test.reshape(-1, 28, 28, 1)
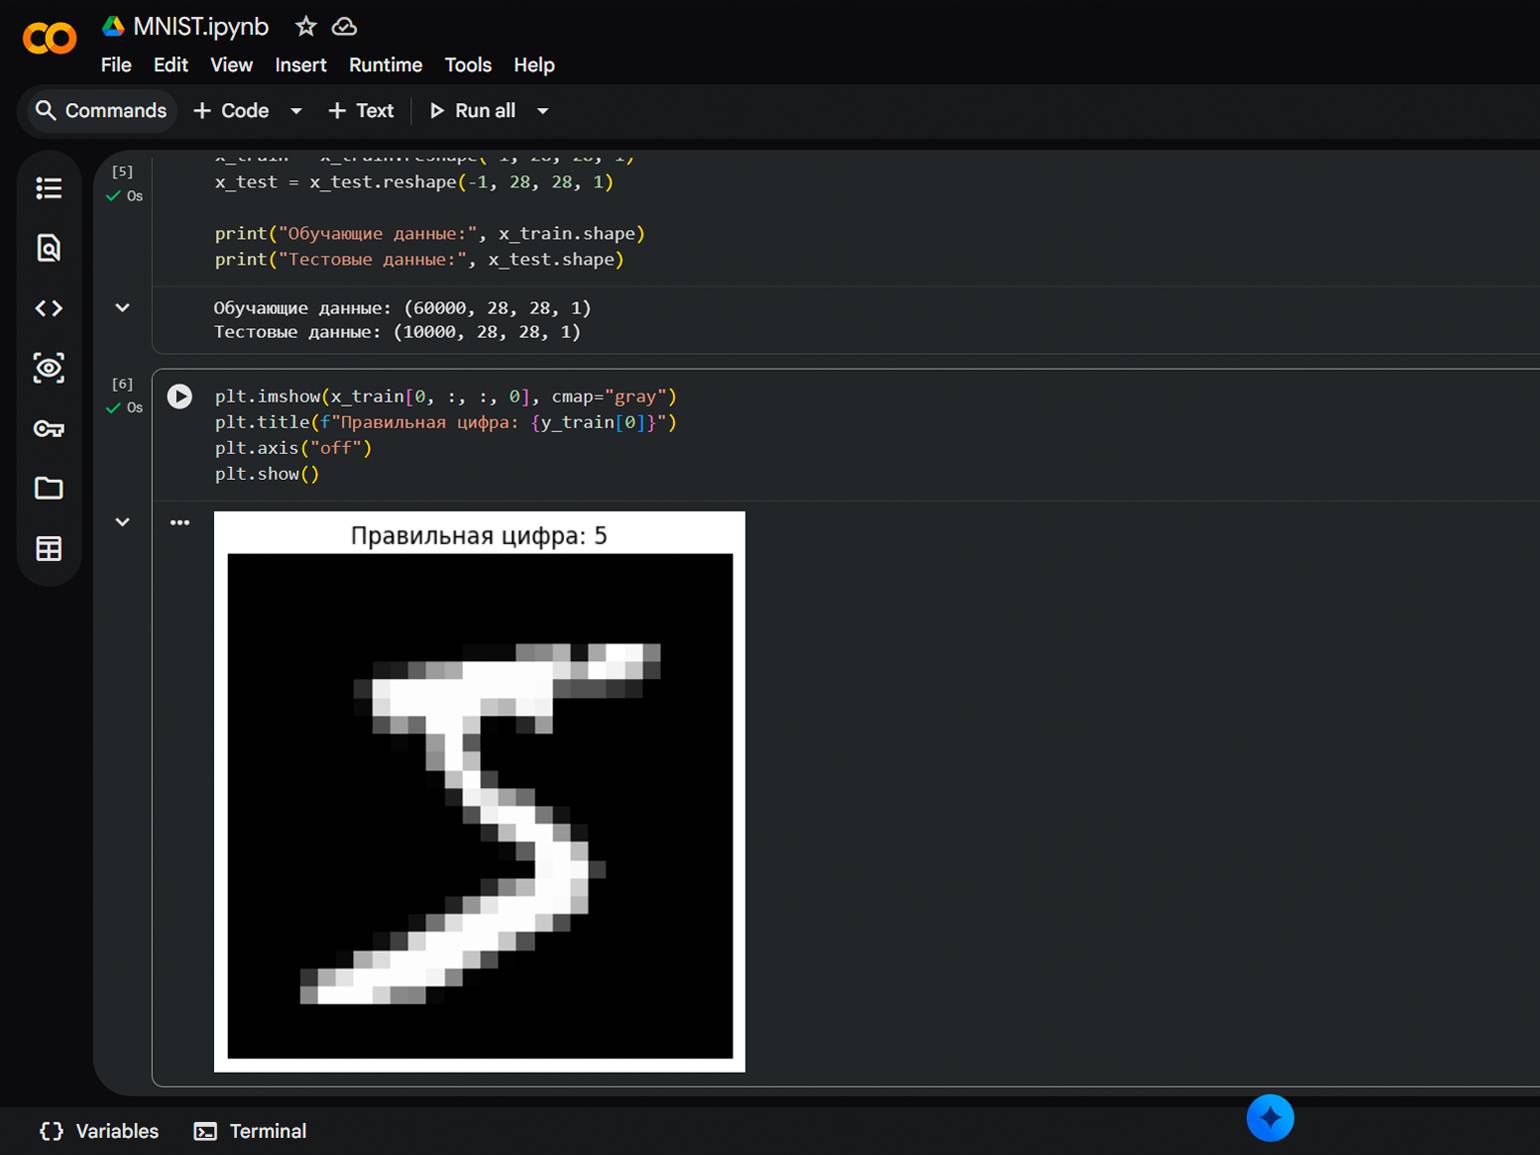
print("Обучающие данные:", x_train.shape)
print("Тестовые данные:", x_test.shape)
Разберём, как работает код. Метод astype («float32») преобразует значения пикселей в числа с плавающей точкой, чтобы после деления на 255 можно было сохранить дробные значения. Затем метод reshape() изменяет форму массивов, добавляя измерение для канала изображения.
В методе reshape() используются четыре параметра:
- -1 — количество изображений. NumPy определяет его автоматически.
- 28, 28 — высота и ширина каждого изображения в пикселях.
- 1 — количество каналов изображения.
После выполнения кода получим следующий результат.
Скриншот: Google Colab / Google / Skillbox Media
Проверим, как выглядит одно из изображений. Для этого воспользуемся библиотекой Matplotlib:
plt.imshow(x_train[0, :, :, 0], cmap="gray")
plt.title(f"Правильная цифра: {y_train[0]}")
plt.axis("off")
plt.show()
Здесь x_train[0, :, :, 0] выбирает первое изображение из обучающего набора. Ноль в начале указывает на номер изображения, два двоеточия позволяют выбрать все строки и столбцы пикселей, а последний ноль — единственный канал яркости.
Функция plt.imshow() отображает изображение, а параметр cmap="gray» задаёт оттенки серого. Команда plt.title() добавляет заголовок с правильной цифрой из массива y_train, plt.axis(«off») скрывает координатные оси, а plt.show() выводит результат.
Под ячейкой появится изображение рукописной цифры и её правильная метка. Так мы убедимся, что данные загружены и подготовлены корректно. На следующем шаге создадим свёрточную нейросеть, которая будет распознавать эти цифры.
Шаг 4: Создайте свёрточную нейросеть
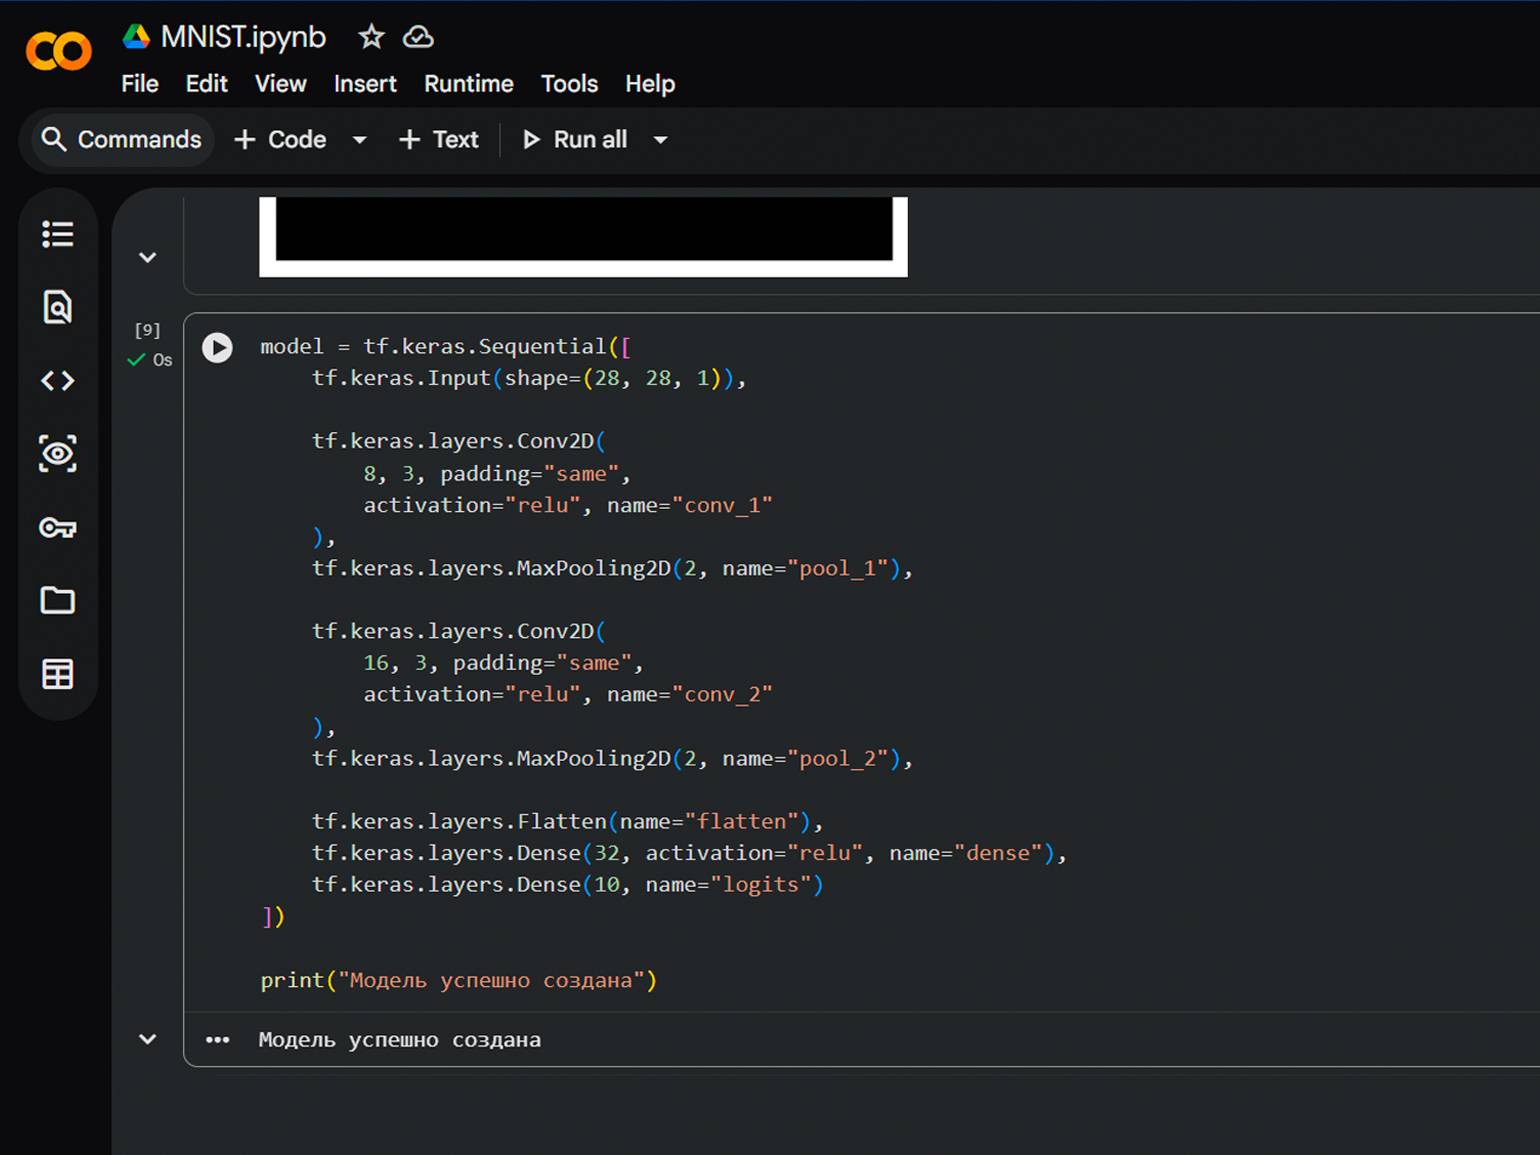
Теперь создадим свёрточную нейросеть (CNN), которая будет распознавать рукописные цифры. Она будет состоять из двух свёрточных слоёв, двух слоёв максимального пулинга и двух полносвязных слоёв. Первые будут выделять признаки изображений, а последние — использовать их для определения цифры.
Для создания модели воспользуемся tf.keras.Sequential. Этот класс позволяет последовательно добавлять слои нейросети: выходные данные одного слоя автоматически передаются следующему.
Выполните код:
model = tf.keras.Sequential([
    tf.keras.Input(shape=(28, 28, 1)),
    tf.keras.layers.Conv2D(
        8, 3, padding="same",
        activation="relu", name="conv_1"
    ),
    tf.keras.layers.MaxPooling2D(2, name="pool_1"),
    tf.keras.layers.Conv2D(
        16, 3, padding="same",
        activation="relu", name="conv_2"
    ),
    tf.keras.layers.MaxPooling2D(2, name="pool_2"),
    tf.keras.layers.Flatten(name="flatten"),
    tf.keras.layers.Dense(32, activation="relu", name="dense"),
    tf.keras.layers.Dense(10, name="logits")
])
print("Модель успешно создана")
Разберём, за что отвечает каждый слой:
- Input (shape=(28, 28, 1)) задаёт форму входных данных. Нейросеть будет получать изображения размером 28×28 пикселей с одним каналом яркости.
- Conv2D выполняет свёртку и выделяет признаки изображений. Первый слой использует восемь фильтров размером 3×3, а второй — 16. Параметр padding="same» позволяет сохранять высоту и ширину карт признаков, а activation="relu» задаёт функцию активации ReLU.
- MaxPooling2D(2) уменьшает высоту и ширину карт признаков вдвое. Благодаря этому сокращается объём данных, которые нужно обрабатывать следующим слоям.
- Flatten преобразует полученные карты признаков в одномерный массив чисел. Это необходимо, чтобы передать данные полносвязным слоям.
- Dense(32, activation="relu») — полносвязный слой из 32 нейронов. Он обрабатывает выделенные признаки и формирует на их основе представление, которое используется для распознавания цифры.
- Dense(10) — выходной слой с десятью нейронами, по одному для каждой цифры от 0 до 9. Он выдаёт десять числовых оценок — логитов. Чем выше логит, тем больше модель склоняется к соответствующему классу.
Параметр name задаёт название слоя. Например, conv_1 — первый свёрточный слой, а pool_1 — первый слой пулинга. Эти названия помогут ориентироваться в архитектуре нейросети.
После выполнения кода появится сообщение «Модель успешно создана». Это означает, что ячейка с кодом выполнилась без ошибок. Пока нейросеть ещё не обучена, поэтому её параметры не настроены для распознавания цифр.
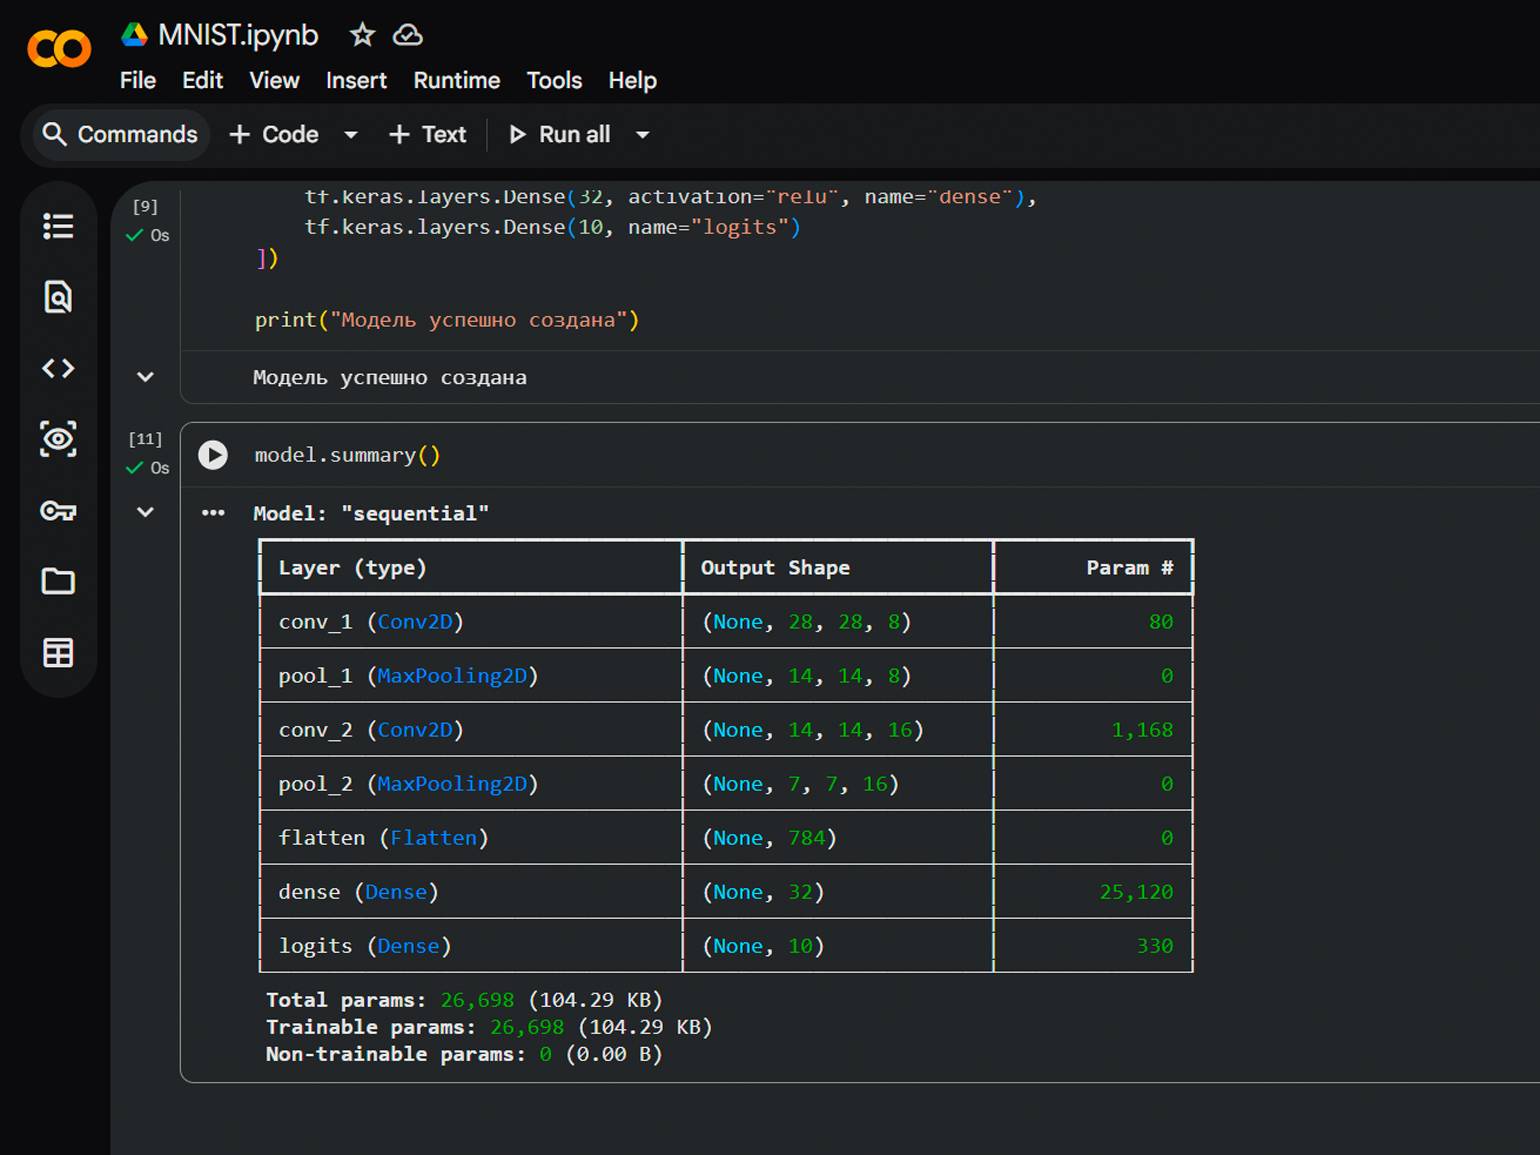
Теперь посмотрим, как устроена модель и как меняются размеры данных после прохождения каждого слоя. Для этого в новой ячейке выполните команду:
model.summary()Метод summary() выводит таблицу с информацией об архитектуре нейросети. Обратите внимание на два столбца:
- Output Shape — форма данных на выходе каждого слоя. Например, после первого свёрточного слоя она составляет (None, 28, 28, 8), а после первого пулинга — (None, 14, 14, 8).
- Param # — количество параметров слоя. Это числовые значения, которые нейросеть будет настраивать во время обучения.
В столбце Output Shape значение None означает, что количество изображений, одновременно передаваемых модели, заранее не задано. Остальные числа показывают высоту, ширину и количество каналов карт признаков. После слоя Flatten форма данных меняется на (None, 784), поскольку 16 карт размером 7×7 преобразуются в массив из 784 чисел.
Всего в нашей нейросети 26 698 обучаемых параметров. Большая часть приходится на первый полносвязный слой Dense (32), который получает 784 входных значения. Каждый из его 32 нейронов связан со всеми входами, поэтому этот слой содержит 25 120 параметров с учётом смещений.
В нижней части таблицы также указано общее количество параметров модели — 26 698. Keras может рассчитать их ещё до обучения, поскольку мы заранее определили форму входных данных с помощью tf.keras.Input (shape=(28, 28, 1)).
Теперь архитектура нейросети готова. На следующем шаге настроим процесс обучения, чтобы модель могла изменять свои параметры и постепенно научилась распознавать рукописные цифры.
Подробнее о параметрах слоёв Conv2D, MaxPooling2D и о методе model.summary() можно узнать в документации Keras.
Шаг 5: настройте обучение
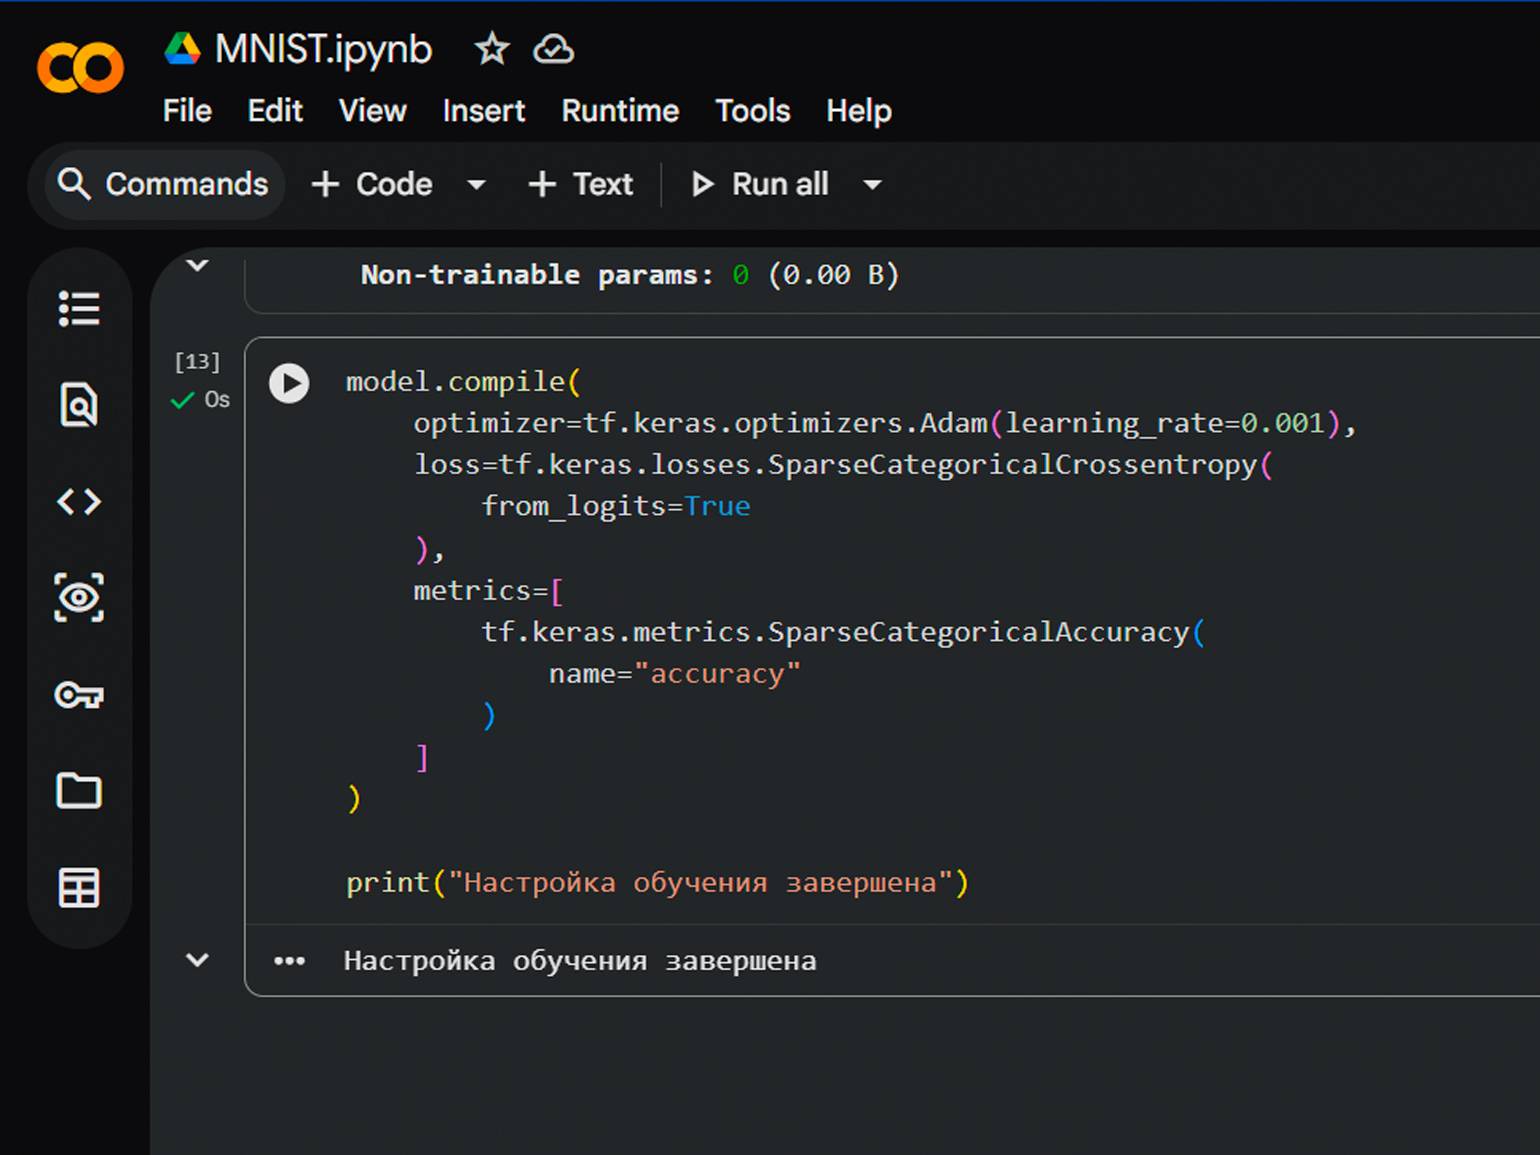
Теперь нужно настроить процесс обучения нейросети. Для этого зададим оптимизатор, функцию потерь и метрику качества. Они определяют, как модель будет изменять свои параметры, оценивать ошибки и отслеживать результаты обучения.
Воспользуемся методом compile(). Он позволяет задать необходимые настройки, но пока не запускает само обучение.
Выполните следующий код:
model.compile(
    optimizer=tf.keras.optimizers.Adam(learning_rate=0.001),
    loss=tf.keras.losses.SparseCategoricalCrossentropy(
        from_logits=True
    ),
    metrics=[
        tf.keras.metrics.SparseCategoricalAccuracy(
            name="accuracy"
        )
    ]
)
print("Настройка обучения завершена")
Разберём основные параметры:
- optimizer — алгоритм, который обновляет веса нейросети во время обучения. Мы используем Adam: он учитывает вычисленные градиенты и адаптирует величину обновлений для разных параметров модели. Значение learning_rate=0.001 задаёт скорость обучения — параметр, влияющий на размер шагов при обновлении весов.
- loss — функция потерь, которая показывает, насколько предсказания модели отличаются от правильных ответов. Мы используем SparseCategoricalCrossentropy, поскольку решаем задачу классификации, а правильные ответы представлены целыми числами от 0 до 9. Параметр from_logits=True указывает, что выходной слой возвращает логиты, а не вероятности.
- metrics — метрики, по которым будем оценивать качество работы нейросети. В нашем случае это SparseCategoricalAccuracy, или доля правильно распознанных изображений. Например, значение accuracy=0.95 означает, что модель верно определила цифры на 95% изображений из оцениваемого набора.
Функция потерь и метрика accuracy решают разные задачи. Функция потерь используется для обновления весов нейросети, а метрика помогает оценивать результаты обучения в понятном виде. При этом высокая точность на обучающих данных ещё не гарантирует, что модель будет так же хорошо распознавать новые изображения.
После выполнения кода появится сообщение «Настройка обучения завершена». Это означает, что ячейка выполнилась без ошибок.
Шаг 6: обучите CNN
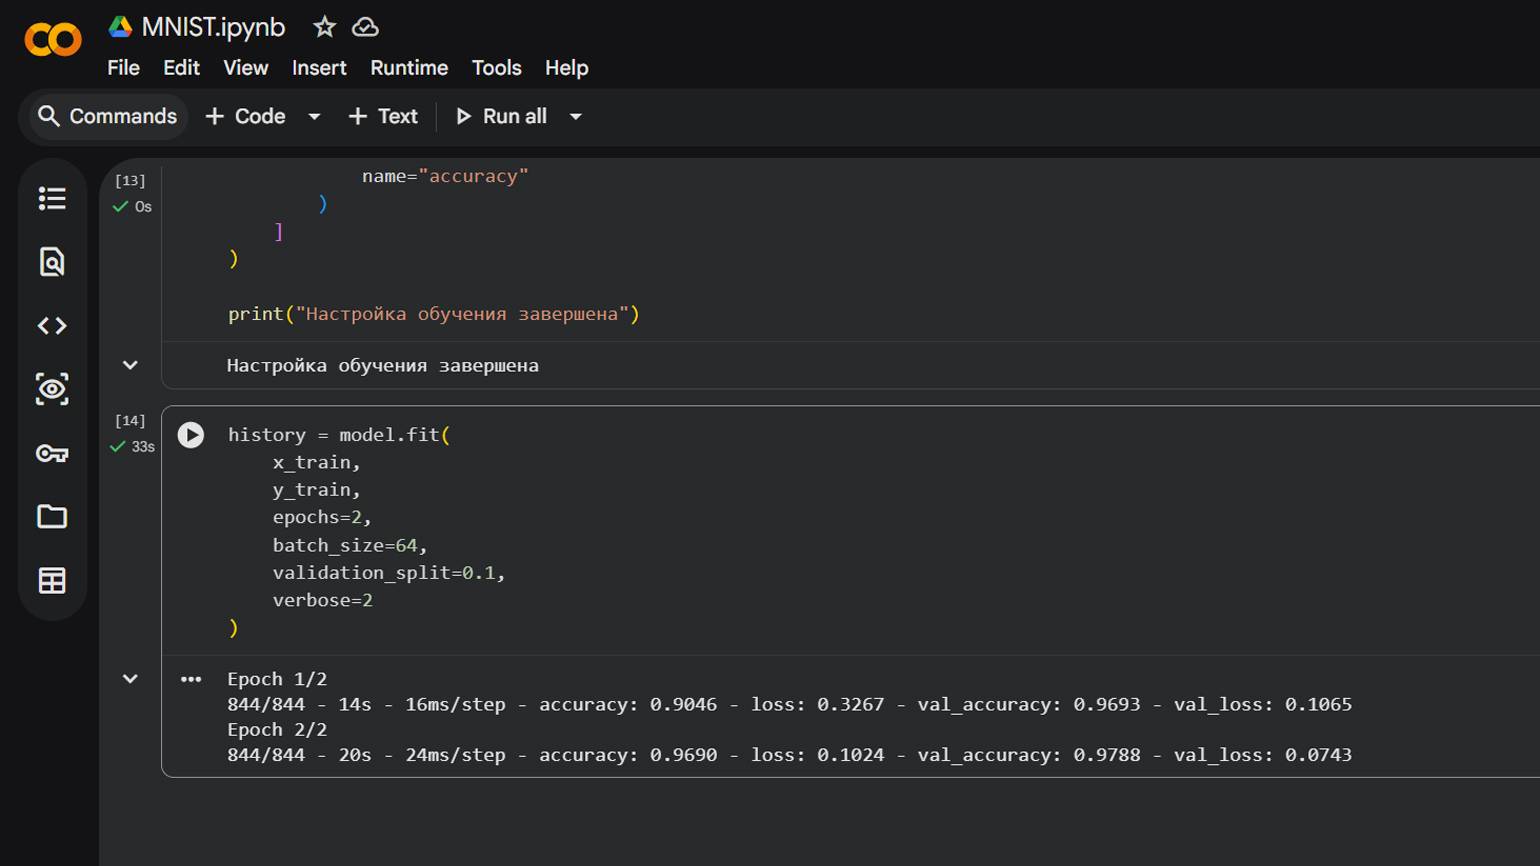
Теперь запустим обучение нейросети с помощью метода fit(). Он будет последовательно передавать изображения в модель, сравнивать её предсказания с правильными ответами и обновлять веса, чтобы постепенно уменьшать ошибки.
Для обучения используем изображения из массива x_train и соответствующие им правильные ответы из y_train.
Выполните следующий код:
history = model.fit(
    x_train,
    y_train,
    epochs=2,
    batch_size=64,
    validation_split=0.1,
    verbose=2
)
Разберём параметры метода fit():
- x_train и y_train — обучающие изображения и правильные ответы. Нейросеть будет использовать их, чтобы научиться распознавать рукописные цифры.
- epochs=2 — количество эпох обучения. Одна эпоха означает, что нейросеть обработала все изображения, выделенные для обучения. В нашем случае она пройдёт по ним дважды.
- batch_size=64 — размер пакета данных. Модель будет обрабатывать изображения группами по 64, вычислять ошибку и обновлять веса после каждого пакета. Последний пакет может содержать меньше изображений.
- validation_split=0.1 — доля данных для проверки качества модели. Keras выделит 10% обучающего набора, то есть 6000 изображений. На оставшихся 54 000 изображениях нейросеть будет обучаться, а на выделенных — проверять качество распознавания после каждой эпохи.
- verbose=2 — формат отображения результатов. После каждой эпохи Colab будет выводить строку с основными показателями обучения.
Результат работы метода fit() сохраняется в переменной history. Она содержит историю обучения: значения функции потерь и метрик после каждой эпохи. Позже эти данные можно использовать для построения графиков.
Во время обучения Colab покажет четыре основных показателя:
- loss — значение функции потерь на обучающих данных. Чем оно ниже, тем меньше ошибка модели по выбранной функции потерь.
- accuracy — доля правильно распознанных изображений при обучении.
- val_loss — значение функции потерь на проверочных данных.
- val_accuracy — доля правильно распознанных изображений на проверочных данных.
Сравнивая эти показатели, можно оценить, как меняется качество работы нейросети от одной эпохи к другой. Например, если loss уменьшается, а accuracy растёт, значит, модель лучше справляется с обучающими изображениями. Показатели val_loss и val_accuracy помогают понять, насколько хорошо она распознаёт данные, которые не использовались для обновления весов.
Обратите внимание: отдельный тестовый набор из 10 000 изображений пока не используется. Он понадобится на следующем этапе, чтобы оценить качество уже обученной нейросети.
Шаг 7: проверьте качество модели
После обучения проверим, насколько хорошо нейросеть распознаёт новые изображения. Для этого используем тестовый набор MNIST, который содержит 10 000 изображений рукописных цифр. Эти данные не участвовали ни в обучении, ни в промежуточной проверке модели.
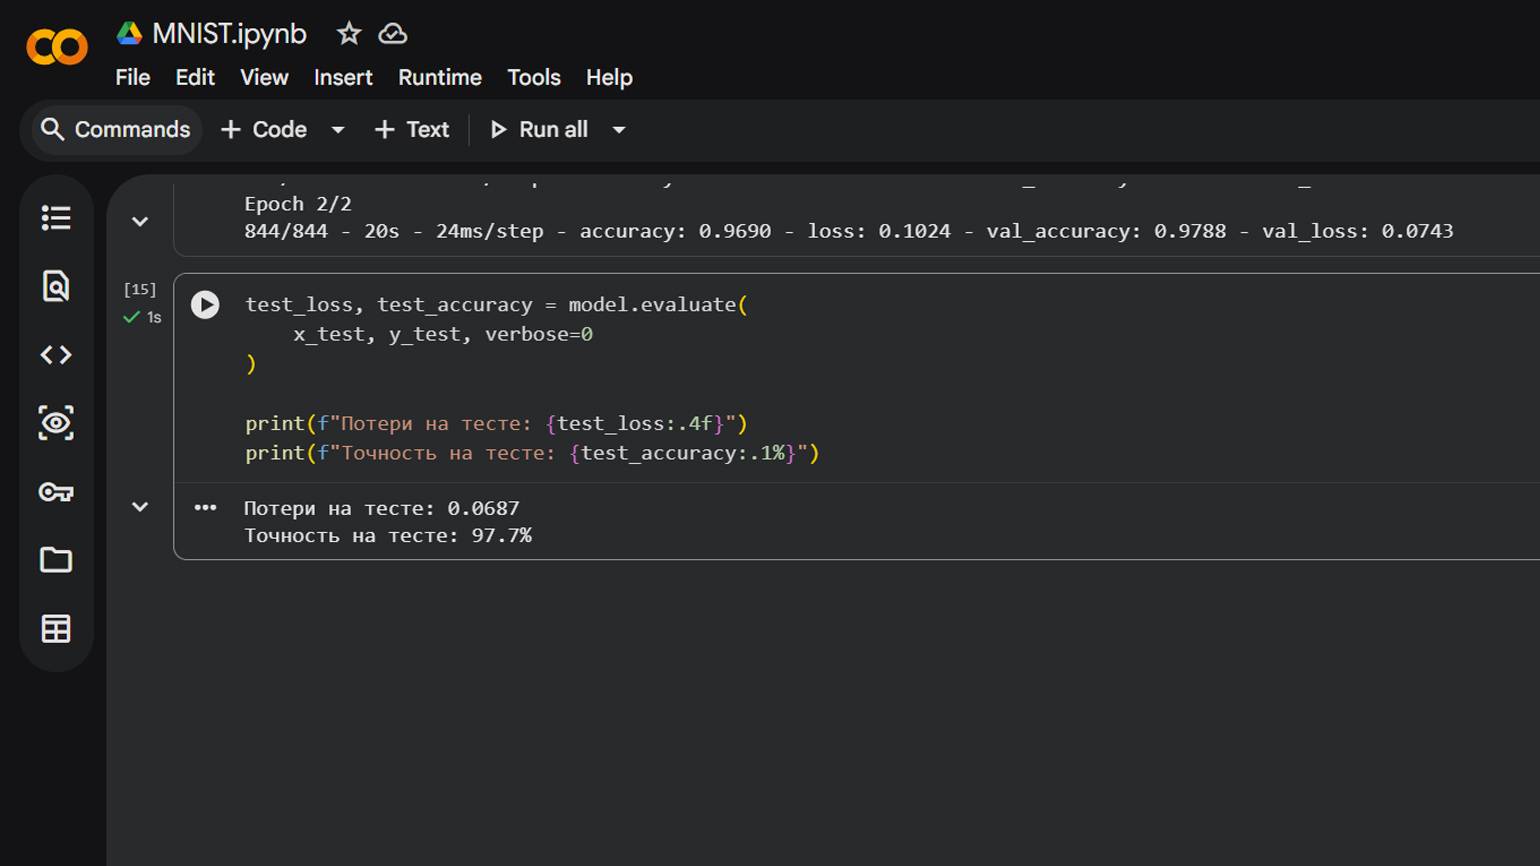
Оценим качество с помощью метода evaluate(). Он передаёт тестовые изображения в нейросеть, сравнивает предсказания с правильными ответами и рассчитывает значения функции потерь и метрики точности.
Выполните следующий код:
test_loss, test_accuracy = model.evaluate(
    x_test, y_test, verbose=0
)
print(f"Потери на тесте: {test_loss:.4f}")
print(f"Точность на тесте: {test_accuracy:.1%}")
Программа выведет величину потерь и долю верно распознанных цифр. Итоговая точность зависит от условий обучения и настроек модели, поэтому конкретные результаты могут различаться. Мы не задаём ожидаемую точность заранее, поскольку она зависит от того, как прошло обучение.
Разберём, как работает код:
- model.evaluate() — метод для оценки качества обученной нейросети. В отличие от fit(), он не обновляет веса модели, а только вычисляет показатели качества.
- x_test и y_test — тестовые изображения и правильные ответы. Модель обрабатывает изображения из x_test, а затем сравнивает свои предсказания с метками из y_test.
- verbose=0 — отключает отображение хода проверки. Вместо промежуточных сообщений мы увидим только результаты, выведенные командой print().
- test_loss и test_accuracy — переменные, в которых сохраняются рассчитанные значения функции потерь и точности распознавания.
Для вывода результатов используем форматированные строки. Выражение {test_loss:.4f} отображает значение функции потерь с четырьмя знаками после запятой, а {test_accuracy:.1%} преобразует точность в проценты с одним знаком после запятой.
После выполнения кода Colab покажет два показателя. Потери на тесте отражают величину ошибки модели по выбранной функции потерь, а точность на тесте показывает долю правильно распознанных цифр. Например, точность 97% означает, что нейросеть верно определила цифры примерно на 9700 из 10 000 тестовых изображений.
Тестирование позволяет оценить, насколько хорошо обученная CNN распознаёт изображения, которые раньше не встречала. Если точность на тестовом наборе близка к точности на проверочных данных, это хороший признак того, что модель способна работать не только с изображениями, использованными для обучения.
Шаг 8: проверьте работу нейросети на реальном примере
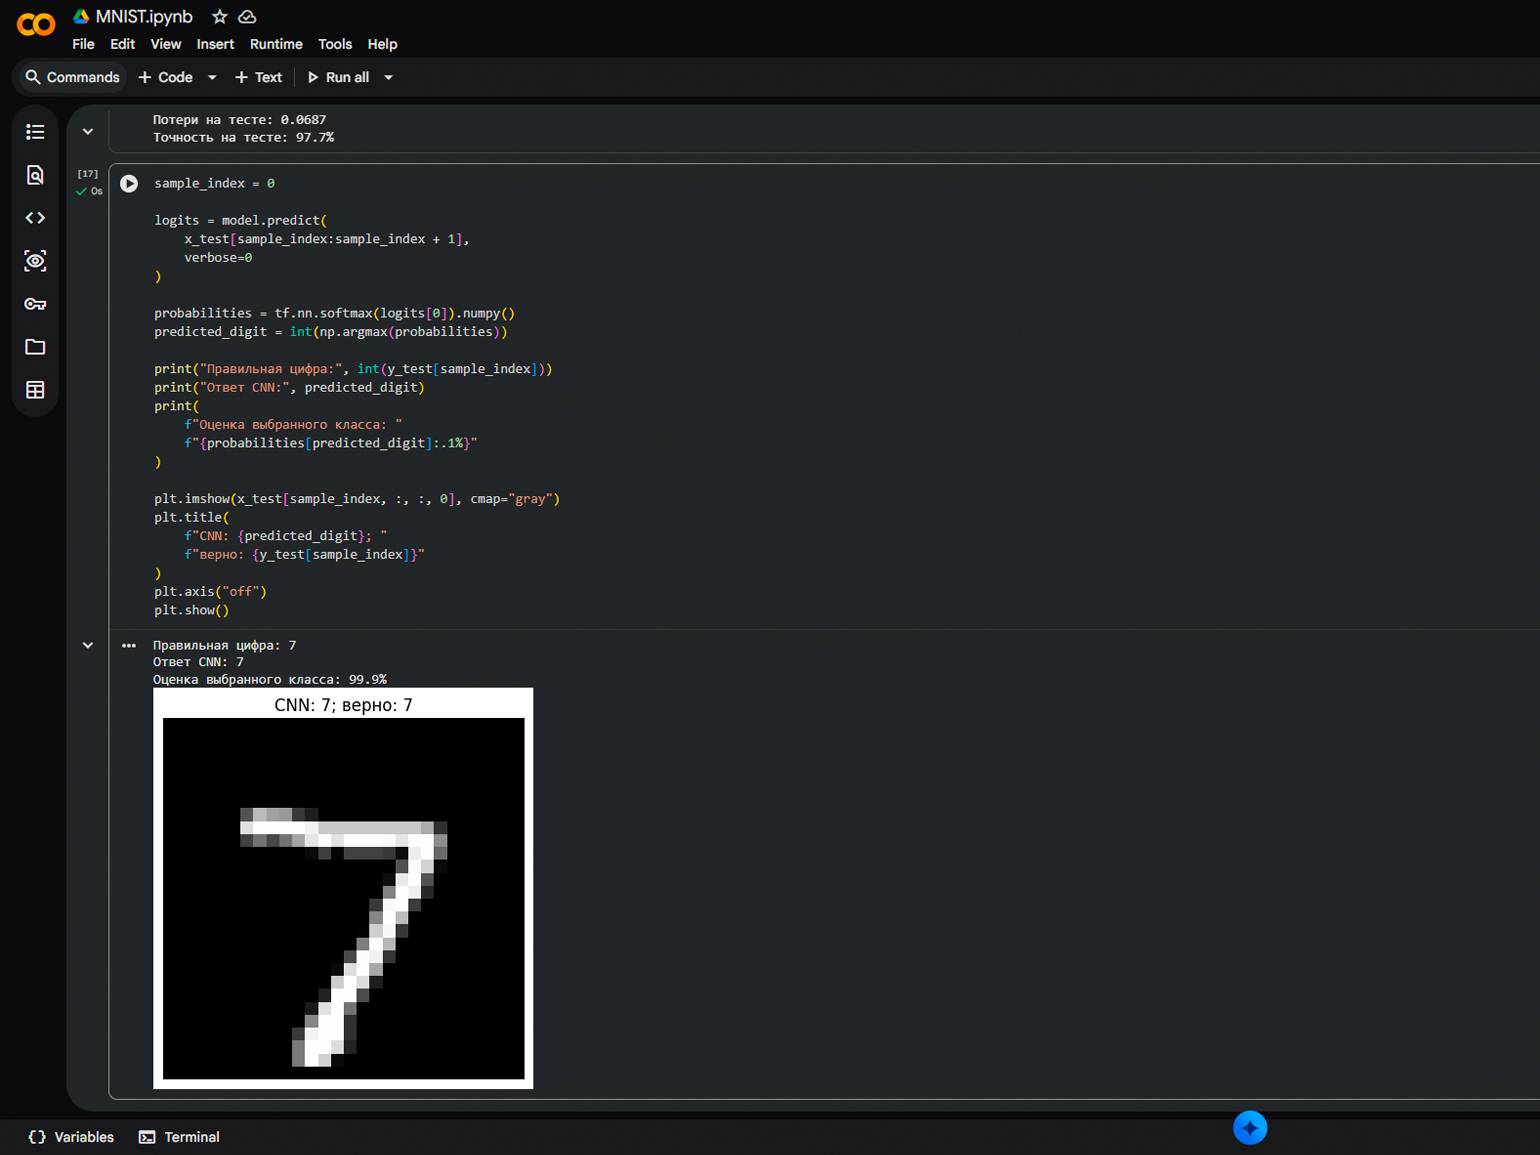
Теперь посмотрим, как обученная нейросеть распознаёт конкретное изображение. Для этого выберем первую цифру из тестового набора MNIST, который не использовался при обучении модели. Передадим изображение в CNN и сравним её предсказание с правильным ответом.
Выполните следующий код:
sample_index = 0
logits = model.predict(
    x_test[sample_index:sample_index + 1],
    verbose=0
)

probabilities = tf.nn.softmax(logits[0]).numpy()
predicted_digit = int(np.argmax(probabilities))
print("Правильная цифра:", int(y_test[sample_index]))
print("Ответ CNN:", predicted_digit)
print(
    f"Оценка выбранного класса: "
    f"{probabilities[predicted_digit]:.1%}"
)

plt.imshow(x_test[sample_index, :, :, 0], cmap="gray")
plt.title(
    f"CNN: {predicted_digit}; "
    f"верно: {y_test[sample_index]}"
)
plt.axis("off")
plt.show()
Метод predict передаёт изображение через обученную сеть. Функция softmax преобразует выходные оценки модели в вероятности для десяти цифр. Затем argmax находит цифру с самой высокой вероятностью.
После выполнения кода под ячейкой появятся результаты классификации и изображение цифры. В первом элементе тестового набора MNIST записана семёрка. Если нейросеть распознала её правильно, значения «Правильная цифра» и «Ответ CNN» совпадут.
Чтобы проверить модель на других изображениях, достаточно изменить значение sample_index. Например, если указать sample_index = 10, нейросеть обработает одиннадцатое изображение из тестового набора.
Скриншот: Google Colab / Google / Skillbox Media
На этом мы завершили практику: создали свёрточную нейросеть, подготовили изображения MNIST, обучили модель и проверили, как она распознаёт новые данные.
Теперь можно экспериментировать с архитектурой CNN: изменять количество свёрточных слоёв и фильтров, увеличивать число эпох и сравнивать результаты. Это поможет лучше понять, как настройки нейросети влияют на качество распознавания изображений.
Преимущества и ограничения CNN
У свёрточных нейросетей есть особенности, которые делают их эффективными при работе с изображениями. Однако CNN подходят не для всех задач. Рассмотрим их основные преимущества и недостатки.
Плюсы CNN:
- Выделение признаков. CNN анализируют небольшие участки изображения и находят на них контуры, текстуры и другие признаки. На следующих слоях нейросеть объединяет простые признаки в более сложные, например характерные для колёс или фар автомобиля.
- Меньше параметров. Один и тот же фильтр применяется к разным участкам изображения. Благодаря этому свёрточным слоям обычно требуется гораздо меньше обучаемых параметров, чем полносвязным слоям при обработке изображений того же размера.
- Распознавание признаков в разных частях изображения. CNN могут находить один и тот же признак независимо от его расположения. Например, нейросеть способна обнаружить колесо автомобиля как в левой, так и в правой части фотографии. Однако поворот или изменение масштаба объекта могут затруднить распознавание.
- Доступные инструменты. В PyTorch и TensorFlow есть инструменты для создания и обучения CNN, а также готовые модели. Их можно адаптировать под новые задачи с помощью переноса обучения (transfer learning).
Минусы CNN:
- Требовательность к ресурсам. Для обучения сложных CNN с нуля могут понадобиться большие наборы изображений и мощные видеокарты. Это увеличивает время и стоимость разработки.
- Сложность анализа удалённых признаков. Свёрточные фильтры обрабатывают небольшие соседние участки изображения. Чтобы учитывать связи между удалёнными объектами, нейросети приходится объединять информацию через несколько слоёв или использовать дополнительные механизмы.
- Чувствительность к изменениям условий. Если CNN обучали на дневных фотографиях, она может хуже распознавать объекты на ночных снимках. Такое снижение качества возможно, когда новые данные существенно отличаются от обучающих. Это явление называют сдвигом распределения (distribution shift).
- Сложность интерпретации результатов. Не всегда понятно, почему CNN распознала объект определённым образом и какие признаки повлияли на её решение. Для анализа используют специальные инструменты, например Grad-CAM. Этот метод помогает визуализировать области изображения, которые сильнее всего повлияли на предсказание модели.
Кроме CNN для обработки изображений используют визуальные трансформеры (vision transformers, ViT). Они разделяют изображение на небольшие участки и с помощью механизма внимания анализируют связи между ними, в том числе между удалёнными частями изображения.
При этом визуальные трансформеры не всегда работают лучше CNN. Выбор архитектуры зависит от задачи, объёма обучающих данных, доступных вычислительных ресурсов и требований к скорости работы модели.
Что нужно запомнить
Повторим главное, что стоит запомнить про свёрточные нейросети:
- Свёрточная нейронная сеть (CNN) — это разновидность нейросети, которая умеет находить характерные признаки в данных. Чаще всего CNN используют для обработки изображений.
- Основу CNN составляют свёрточные слои. Они применяют фильтры, которые выделяют контуры, текстуры и другие признаки. Следующие слои объединяют их в более сложные сочетания.
- Главное преимущество CNN — возможность находить признаки в разных частях изображения, используя сравнительно небольшое количество обучаемых параметров.
- CNN применяют для классификации изображений, обнаружения объектов, сегментации и других задач компьютерного зрения.
- У CNN есть ограничения. Обучение сложных моделей требует данных и вычислительных ресурсов, а качество распознавания может снижаться, если новые изображения сильно отличаются от обучающих.
Больше интересного про код — в нашем телеграм-канале. Подписывайтесь!

Профессия Machine Learning Engineer
- Все необходимые для ML-инженера навыки
- Практика на реальных данных от компаний
- Практика в Kaggle — сможете работать с реальными дата-сетами