Все
 Истории
 Дизайн
 Код
 Геймдев
 Бизнес
 Маркетинг
 Управление
 Кино
 Музыка
 Проектная фотография
 Развитие
 Деньги
 Здоровье
 Образование
 EdTech
 Корп. обучение
 Блог Skillbox
 Глоссарий
 Спецпроекты

Токены в нейросетях: что это, как они работают и зачем их считать
Разбираемся, как нейросети делят текст на части и как это влияет на стоимость генерации.
Когда вы общаетесь с нейросетью, объём текста имеет значение. Например, модель может отредактировать короткую заметку, но не справиться с целой книгой за один запрос. Дело в том, что языковые модели обрабатывают текст в виде токенов, количество которых ограничено.
От числа токенов зависит не только то, сколько информации может обработать LLM, но и стоимость использования ИИ-сервисов через API.
В этой статье мы разберёмся, что такое токены, как в нейросетях работает токенизация текста, как подсчитать токены и сократить их расход.
Содержание
- Что такое токен
- Как токенизатор разбивает текст
- Что языковая модель делает с токенами
- Что влияет на количество токенов в тексте
- Как модели обрабатывают изображения, аудио и видео
- Что такое контекстное окно
- Как посчитать токены в запросе и ответе
- Сколько стоят токены в разных моделях
- Как сократить расход токенов
- Что запомнить
Что такое токен
Токен — это единица информации, с которой работает языковая модель. При обработке текста токеном может быть целое слово, его часть, знак препинания или несколько символов.
Например, короткое и часто встречающееся слово может соответствовать одному токену, а длинное или редкое — состоять из нескольких. Как именно текст делится на токены, зависит от токенизатора — специальной программы, которая выполняет эту задачу.
Когда нейросеть создаёт ответ, она не генерирует весь текст сразу. Вместо этого модель последовательно выбирает следующий токен с учётом запроса и предыдущего текста. Так постепенно формируется ответ.
В переводе с английского token означает «знак», «символ» или «жетон». Этот термин используют в разных областях. Например, токеном могут называть электронный ключ безопасности или цифровой актив в блокчейне. Но в контексте нейросетей у слова другое значение.
Как токенизатор разбивает текст
Прежде чем языковая модель начнёт обрабатывать текст, специальная программа разбивает его на токены. Алгоритм разбивки зависит от конкретного варианта токенизатора.
Например, токенизатор модели Qwen2.5 может разделить фразу «Кот спит.» на следующие части:
К|от| сп|ит|.
Обратите внимание: пробел перед словом «спит» входит в токен сп, а точка стала отдельным токеном.
Разные токенизаторы могут разбивать один и тот же текст по-разному. Это зависит от их словарей и алгоритмов. Один из распространённых алгоритмов — BPE (byte pair encoding). Он позволяет создавать токены из часто встречающихся последовательностей символов.
В алгоритме BPE
Для обучения токенизатора используют большой набор текстов: книги, статьи, сайты и другие материалы. Алгоритм BPE ищет в них часто встречающиеся сочетания и постепенно объединяет их в более крупные токены.
Разберём этот процесс на упрощённом примере. Предположим, в обучающих текстах регулярно встречаются три слова: «лес» — 100 раз, «лет» — 80 раз и «сел» — 20 раз.
Для простоты объяснения представим, что каждая буква в словах — это отдельный токен:
лес → л|е|с
лет → л|е|т
сел → с|е|л
После этого алгоритм подсчитывает, сколько раз каждая пара соседних токенов встречается в обучающих текстах.
Например, сочетание л + е встречается 180 раз: 100 раз в слове «лес» и ещё 80 раз в слове «лет». Это самая частая пара в нашем примере, поэтому алгоритм объединяет её в новый токен ле.
Теперь разбивку слов можно представить по новому:
лес → ле|с
лет → ле|т
сел → с|е|л
Алгоритм снова подсчитывает частоту соседних пар, но уже с учётом предыдущего объединения.
Теперь сочетание ле + с встречается 100 раз, а ле + т — 80 раз. Самой частой оказывается первая пара, поэтому алгоритм объединяет её в токен лес.
ле|с → лес
В словаре появляется новый токен, соответствующий целому слову «лес».
Затем алгоритм снова ищет самую частую пару и объединяет её. Процесс повторяется, пока словарь не достигнет заданного размера.
При этом сохраняются не только полученные токены, но и правила их объединения. В нашем примере сначала появилось правило л + е → ле, а затем ле + с → лес.
Когда токенизатор получает новый текст, он применяет изученные правила и разбивает текст на токены. Ему уже не нужно заново подсчитывать частоту сочетаний.
Важно! В приведённом примере мы начали с отдельных букв. Но некоторые токенизаторы, в том числе Qwen, используют разновидность BPE, которая работает с байтами. В этом случае компьютер хранит текст в виде чисел. Например, в кодировке UTF-8 кириллическая буква «к» представлена двумя байтами со значениями 208 и 186.
При байтовой токенизации алгоритм сначала работает с отдельными байтами, а затем объединяет часто встречающиеся последовательности. Поэтому границы токенов могут проходить даже внутри одного символа. Это одна из причин, по которым количество токенов не всегда совпадает с количеством слов или символов в тексте.
В алгоритмах WordPiece и Unigram
Кроме BPE, для разбиения текста на токены используют и другие алгоритмы. Самые распространённые варианты — WordPiece и Unigram. Рассмотрим каждый из них.
WordPiece ищет в словаре самый длинный фрагмент, который совпадает с началом слова. Затем повторяет поиск для оставшейся части, пока не разобьёт всё слово на токены.
Например, возьмём слово «пароход». Предположим, что целиком его в словаре нет, но есть фрагменты паро и ##ход. Тогда WordPiece разделит слово на два токена:
паро | ##ход
Символы ## обозначают, что токен продолжает слово, а не начинает новое. Если токенизатор не сможет подобрать подходящие фрагменты для всего слова, в стандартной реализации WordPiece он заменит его специальным токеном [UNK] — «неизвестное слово».
Unigram работает иначе. Вместо того чтобы последовательно выбирать самые длинные фрагменты, он рассматривает разные варианты разбиения и оценивает, какой из них наиболее вероятен.
Допустим, слово «самолёт» можно разделить двумя способами:
само|лёт
сам|олёт
Для каждого фрагмента в словаре Unigram хранится вероятность, рассчитанная во время обучения. Чтобы оценить вариант разбиения, алгоритм перемножает вероятности всех входящих в него токенов.
Предположим, что произведение вероятностей для сочетания само|лёт выше, чем для сам|олёт. Тогда токенизатор выберет первый вариант и вернёт два токена: само и лёт.
Таким образом, BPE использует заранее изученные правила объединения, WordPiece ищет самые длинные подходящие фрагменты, а Unigram выбирает наиболее вероятное разбиение. При этом все три алгоритма решают одну задачу — преобразуют текст в последовательность токенов, которую затем может обработать языковая модель.
Что языковая модель делает с токенами
После токенизации каждый токен получает числовой идентификатор — ID. По этим идентификаторам нейросеть находит числовые представления токенов, которые называют эмбеддингами. Они позволяют ей выполнять математические вычисления, учитывать порядок токенов и связи между ними.
На основе этих вычислений модель определяет, какие токены могут продолжить текст, и оценивает вероятность каждого варианта.
Представим, что нейросети нужно продолжить фразу «Завтра мы». Возможных вариантов много: «поедем», «встретимся», «будем» и другие. Какое продолжение выберет модель, зависит от исходного запроса и предыдущего текста. Например, если речь в предыдущем сообщении шла о планах на отпуск, она может сгенерировать фразу «Завтра мы поедем на море».
Для простоты предположим, что каждое слово и знак препинания в нашем примере соответствуют отдельному токену. Тогда процесс генерации будет выглядеть так:
Завтра мы
Завтра мы поедем
Завтра мы поедем на
Завтра мы поедем на море
Завтра мы поедем на море.
На каждом шаге модель оценивает вероятности следующих токенов с учётом исходного запроса и уже сгенерированного текста. Выбранный токен добавляется к последовательности, после чего процесс повторяется. Если слово состоит из нескольких токенов, модель генерирует их по отдельности.
При этом модель не всегда выбирает наиболее вероятный токен. Существуют разные способы генерации. Например, можно каждый раз выбирать вариант с наибольшей вероятностью или случайным образом выбирать токен с учётом распределения вероятностей. Второй способ позволяет получать более разнообразные ответы. Поэтому на один и тот же вопрос нейросеть может отвечать по-разному.
Генерация заканчивается, когда модель создаёт специальный токен завершения или срабатывает одно из заданных ограничений, например на максимальную длину ответа.
После этого полученные ID токенов преобразуются обратно в текст. Если сервис поддерживает потоковую выдачу, пользователь видит ответ постепенно, по мере генерации новых токенов.
Что влияет на количество токенов в тексте
Иногда для подсчёта токенов используют простое правило: один токен равен примерно четырём символам. Но это лишь приблизительная оценка, которая лучше подходит для английского текста. На практике количество токенов зависит от нескольких факторов.
Тип токенизатора
Один и тот же текст может занимать разное количество токенов. Дело в том, что токенизаторы разных моделей используют разные словари и правила разбиения текста.
Например, токенизатор OpenAI o200k_base делит фразу «Нейросеть считает токены.» на восемь токенов:
Н|ей|рос|еть| считает| ток|ены|.
А токенизатор модели Qwen2.5-7B-Instruct — на десять:
Н|ей|рос|еть| счит|ает| т|ок|ены|.
В первом случае слово «считает» занимает один токен, во втором — два. Это связано с тем, что в словарях представлены разные сочетания символов. Чем больше подходящих слов и сочетаний есть в словаре, тем меньше токенов может потребоваться для обработки текста.
Поэтому при переходе с одной модели на другую количество токенов может измениться, даже если сам текст остался прежним.
Язык текста
Количество токенов зависит и от языка. Например, русский текст в некоторых токенизаторах занимает больше токенов, чем английский с тем же содержанием.
В исследовании 2023 года учёные сравнили токенизацию предложений, переведённых на разные языки. Оказалось, что токенизатор cl100k_base, который использовали модели OpenAI, в среднем расходовал на русский текст в 2,49 раза больше токенов, чем на английский.
Причина заключается в устройстве словаря. Если токенизатор приспособлен к английскому языку, распространённые английские слова могут занимать один токен, а русские — разбиваться на несколько. Влияют и особенности языка: например, в русском у одного слова может быть много форм с разными окончаниями.
Однако соотношение зависит от токенизатора. Более современные словари могут эффективнее обрабатывать русский и другие языки.
Особенности написания слов и предложений
Даже небольшие изменения в тексте могут повлиять на количество токенов. Например, в токенизаторе o200k_base слово чай занимает один токен, а Чай — два: Ч | ай.
Пробелы тоже имеют значение. Слова «чай» и « чай» могут занимать по одному токену, но их идентификаторы будут разными. Во втором случае пробел входит в состав токена.
На разбиение также влияют числа, знаки препинания, переносы строк и специальные символы. При этом изменение написания не обязательно увеличивает количество токенов: иногда оно остаётся прежним или даже уменьшается.
Точно определить количество токенов по числу слов или символов нельзя. Если нужно проверить, поместится ли текст в контекстное окно модели или сколько будет стоить запрос через API, лучше воспользоваться счётчиком токенов для выбранной модели.
Как ИИ-модели обрабатывают изображения, аудио и видео
Нейросети работают с токенами при обработке не только текста, но и изображений, аудио и видео. Для этого они преобразуют исходные данные в числовые представления, с которыми может работать модель. Способы такого преобразования зависят от типа данных и архитектуры нейросети. Разберём каждый из них подробнее.
Изображения
Для обработки изображений многие нейросети делят их на небольшие квадратные участки — патчи. Например, один из вариантов модели Vision Transformer использует патчи размером 16×16 пикселей.
Представим, что вы загрузили фотографию велосипеда. Одни патчи будут содержать части колёс, другие — раму, третьи — фон. При этом границы участков не зависят от расположения предметов: в одном патче могут оказаться край колеса и трава за ним.
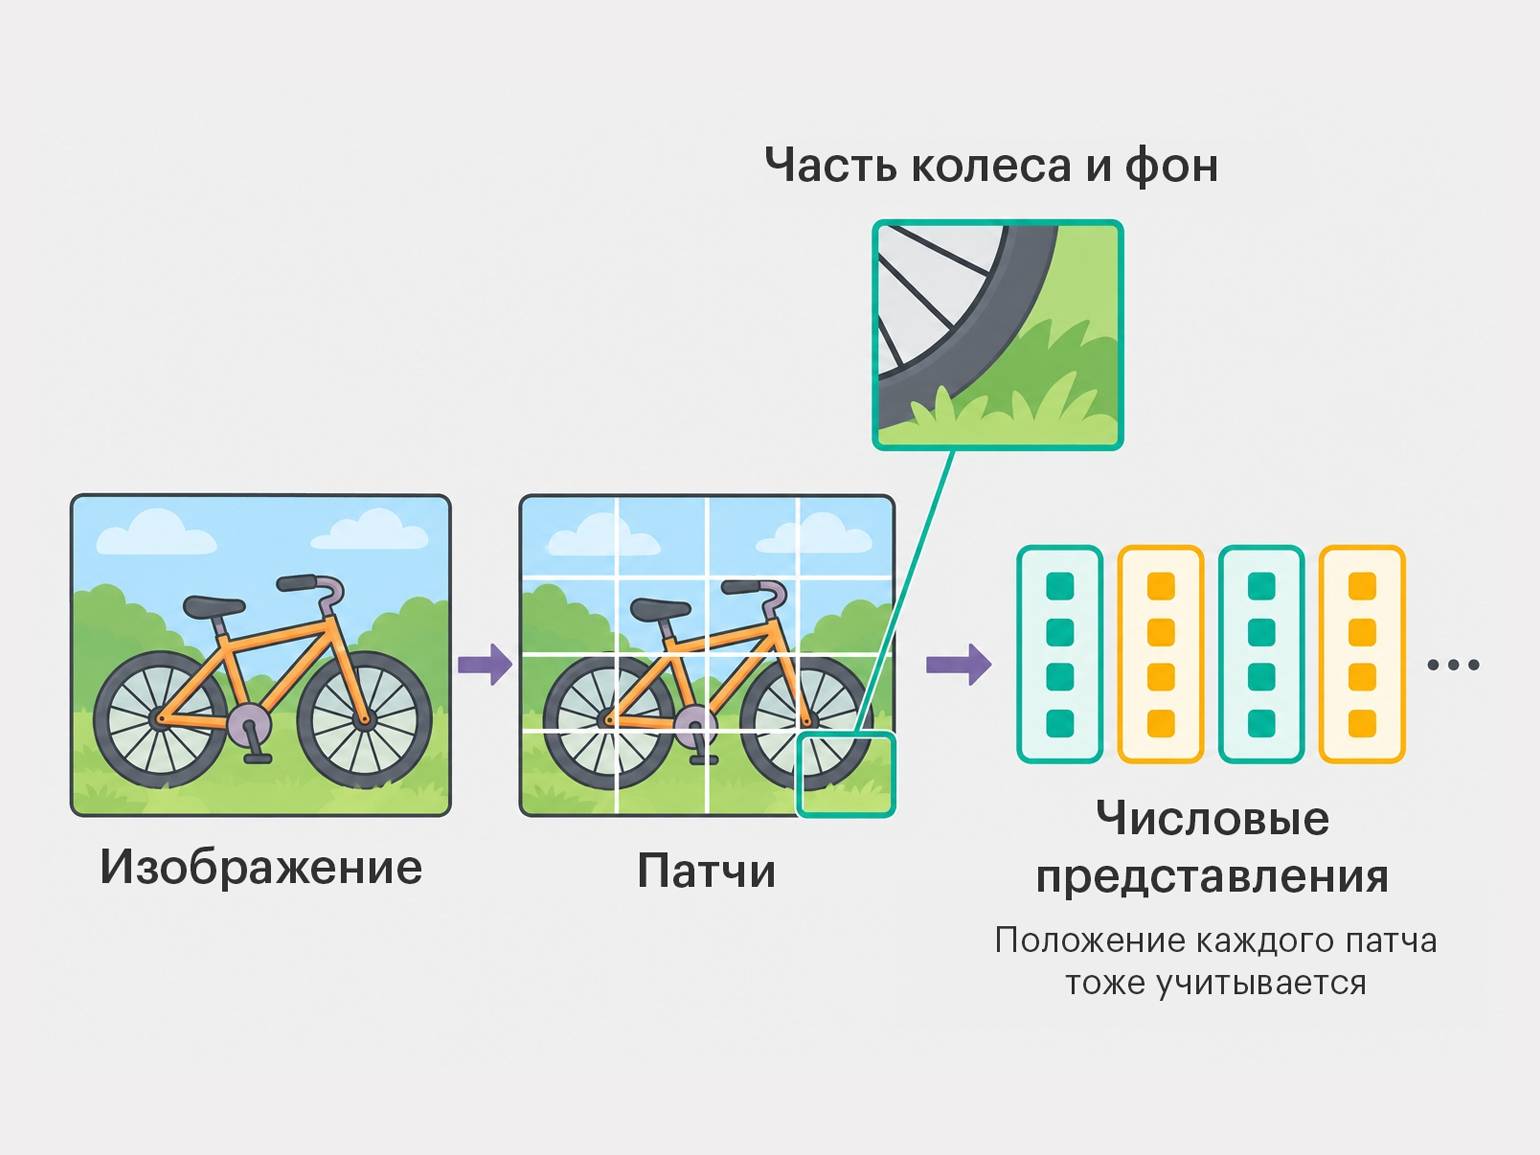
Затем каждый патч преобразуется в набор чисел — вектор. К нему добавляется информация о расположении участка на изображении. Такие представления называют визуальными токенами. Анализируя их вместе, модель может распознавать формы и объекты — например, определять, что на фотографии велосипед.
Количество визуальных токенов зависит от размера изображения и способа его обработки. Если размер патчей остаётся неизменным, более крупная картинка потребует больше токенов. Чтобы сократить их количество, модель может предварительно уменьшить изображение. Однако при этом часть мелких деталей, например надпись на раме велосипеда, может стать менее различимой.
У разных моделей разные способы обработки изображений и подсчёта токенов. Поэтому точный расход токенов лучше проверять с помощью инструментов выбранного сервиса.
Видео
При обработке видео нейросети нужно учитывать не только содержимое отдельных кадров, но и изменения между ними. Для этого она преобразует видеоряд в числовые представления, которые можно использовать для вычислений.
Один из способов показан на иллюстрации. Сначала видео разделяется на отдельные кадры, затем каждый кадр — на небольшие участки (те же патчи). Они преобразуются в визуальные токены, которые поступают в трансформер. При этом модель учитывает не только содержимое фрагментов, но и их расположение в кадре и последовательность во времени.
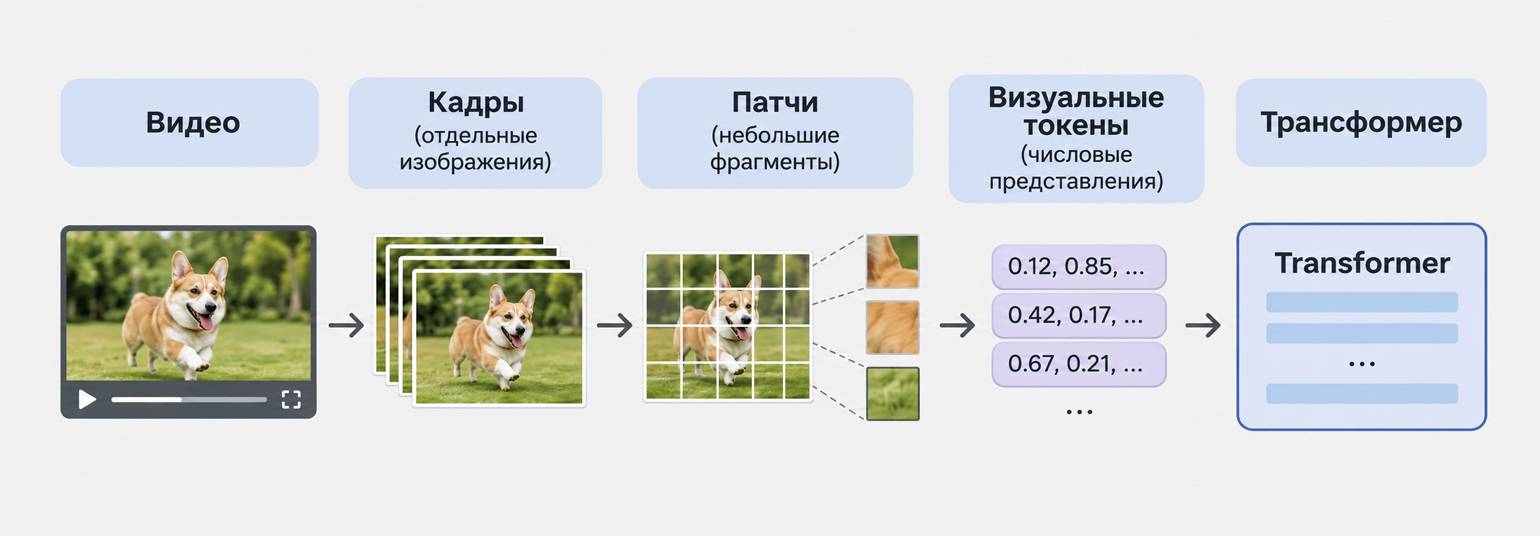
Некоторые модели используют более сложный подход. Например, первая Sora сначала сжимает видео в компактное числовое представление, а затем разделяет его на пространственно-временные патчи. Каждый такой патч охватывает определённый участок изображения сразу на нескольких соседних кадрах.
Представим ролик, в котором человек поворачивает голову. Анализируя информацию из разных кадров, модель может учитывать движение головы и сохранять внешность человека на протяжении всего видео.
При создании новых роликов некоторые модели, в том числе первая Sora, используют диффузионный подход. Генерация начинается со случайного шума, который нейросеть постепенно преобразует в видео, ориентируясь на текстовый запрос. После этого декодер превращает полученное числовое представление в готовые кадры.
Таким образом, при работе с видео токены могут содержать информацию не только об отдельных участках изображения, но и об их изменениях во времени.
Аудио
Для обработки аудио нейросети преобразуют звуковую запись в числовые данные. Один из способов — построить спектрограмму. Она показывает, какие частоты присутствуют в звуке и как меняется их интенсивность со временем. Например, на спектрограмме можно увидеть различия между человеческой речью, музыкой и паузами.
Некоторые модели, например Audio Spectrogram Transformer, разделяют спектрограмму на небольшие участки — патчи. Каждый патч содержит информацию о частотах звука за определённый промежуток времени.
Затем патчи преобразуются в числовые векторы — аудиотокены, которые поступают в трансформер. Анализируя их вместе, модель может распознавать речь и другие звуки, например определять, что человек разговаривает на фоне музыки.
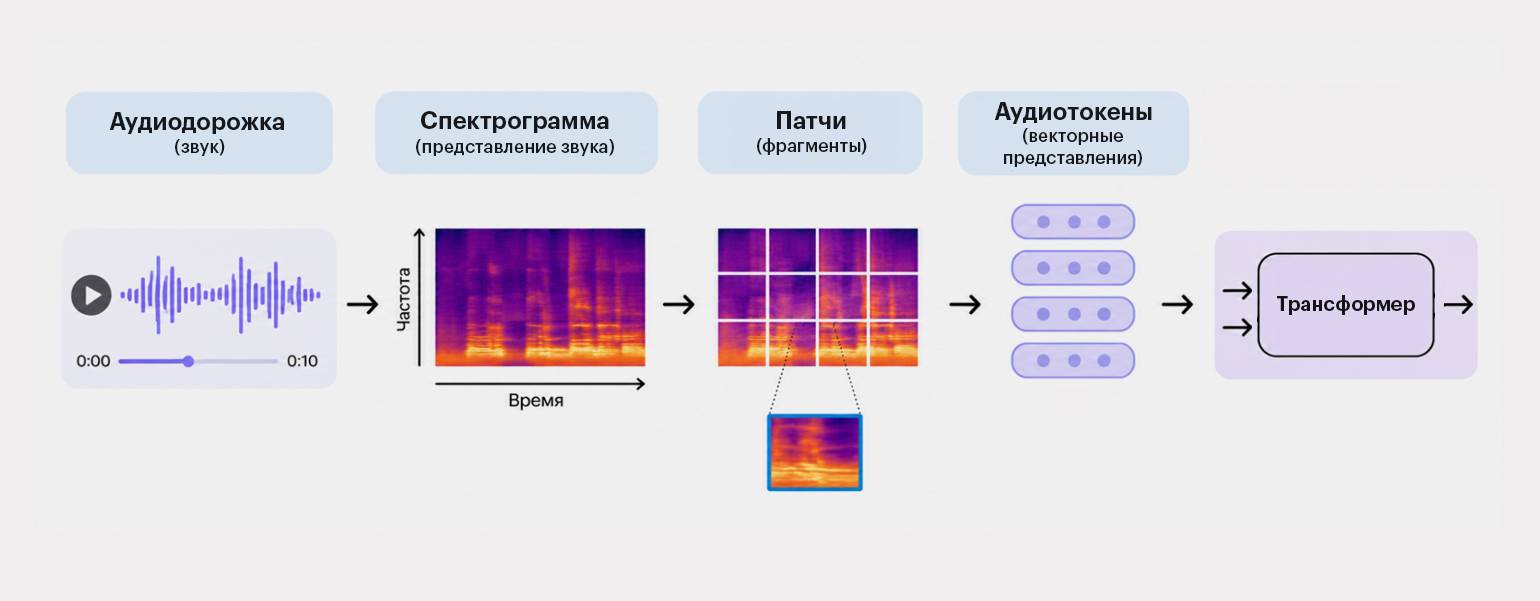
Но не все нейросети обрабатывают аудио одинаково. Например, Qwen2-Audio тоже использует спектрограмму, однако преобразует её в числовые представления с помощью специального аудиоэнкодера, не разделяя на квадратные патчи по схеме выше.
Есть и другой подход: сначала система распознаёт речь и переводит её в текст. Например, из аудиозаписи получается фраза «Заказ доставят завтра». Токенизатор разбивает её на обычные текстовые токены, с которыми затем работает языковая модель.
Такого представления хватит, чтобы ответить на вопрос «Когда доставят заказ?». Но если нужно определить интонацию говорящего или распознать музыку на фоне, одной текстовой расшифровки может быть недостаточно.
Что такое контекстное окно
У каждой языковой модели есть ограничение на количество токенов, которые она может учитывать при подготовке ответа. Этот объём называют контекстным окном. От его размера зависит, сколько информации нейросеть может обработать за одно обращение.
Когда вы отправляете сообщение, модель может получать не только ваш запрос, но и историю переписки, прикреплённые документы, результаты поиска и служебные инструкции приложения. Всё это занимает место в контекстном окне.
Токены, которые модель получает для обработки, называют входными, а те, которые создаёт при генерации ответа, — выходными. В большинстве современных языковых моделей и те и другие учитываются в пределах контекстного окна.
Предположим, размер контекстного окна составляет 32 000 токенов. Ваш запрос, история переписки и прикреплённая статья вместе занимают 26 000 токенов. Тогда для генерации ответа остаётся:
32 000 − 26 000 = 6000 токенов.
Однако это не значит, что модель сможет сгенерировать ответ на 6000 токенов. У неё может быть отдельное ограничение на длину ответа — output token limit. Например, если оно составляет 4000 токенов, модель не сможет выдать больше, даже если в контекстном окне осталось свободное место.
У некоторых моделей часть выходных токенов также расходуется на внутренние рассуждения — thinking tokens. Они не отображаются в готовом ответе, но могут учитываться в общем лимите генерации.
При работе с файлами расход токенов зависит от того, как приложение обрабатывает их содержимое. Например, при загрузке PDF сервис может извлечь текст, преобразовать страницы в изображения или передать модели только нужные фрагменты. Поэтому определить требуемое количество токенов только по размеру файла или числу страниц нельзя.
Что произойдёт, если контекстное окно заполнится? Это зависит от модели и приложения. Сервис может отклонить слишком большой запрос или автоматически сократить историю переписки, удалив старые сообщения либо заменив их кратким пересказом. Например, Claude поддерживает автоматическое сокращение истории диалога.
При этом пользователь может по-прежнему видеть всю переписку, хотя модель получает только её часть. Поэтому в длинных диалогах нейросеть иногда перестаёт учитывать требования, сформулированные в начале разговора.
Как посчитать токены в запросе и ответе
Чтобы узнать, сколько токенов занимает текст, можно воспользоваться токенизатором OpenAI или аналогичным инструментом для выбранной модели. Достаточно вставить текст в специальное поле, и сервис покажет количество токенов и то, на какие части он разбивается.
Таким способом можно проверить не только обычный текст, но и программный код. Однако результат будет относиться только к вставленному фрагменту. Если запрос содержит историю переписки, изображения или файлы, их расход потребуется учитывать отдельно.
Для более точного подсчёта перед отправкой запроса можно использовать инструменты API. Например, OpenAI позволяет подсчитать входные токены с учётом текста, изображений, файлов и служебных инструкций. Аналогичныйинструмент есть у Claude. При этом фактический расход может немного отличаться от предварительной оценки.
После выполнения запроса API обычно возвращает не только ответ модели, но и информацию об использованных токенах. Чаще всего эти данные находятся в поле usage.
Например, OpenAI Responses API показывает:
- input_tokens — количество входных токенов;
- output_tokens — количество выходных токенов;
- reasoning_tokens — количество токенов, использованных для рассуждений модели, если такие данные доступны.
Последний показатель входит в общее количество выходных токенов, поэтому складывать output_tokens и reasoning_tokens не нужно.
Фактический расход может оказаться больше, чем количество токенов в видимом ответе. Это связано с тем, что модель может использовать токены для рассуждений и формирования служебной структуры ответа.
Для расчёта стоимости запросов через API лучше ориентироваться на данные usage, а не подсчитывать токены самостоятельно. Также нужно учитывать тарифы модели и особенности оплаты кэшированных токенов.
Сколько стоят токены в разных моделях
При работе с нейросетями через API пользователь платит за количество обработанных токенов. Для входных и выходных токенов устанавливают отдельные тарифы, причём генерация ответа обычно обходится дороже обработки запроса.
Стоимость указывают за миллион токенов, но платить за весь миллион сразу не нужно. Например, если запрос занял всего 1000 токенов, оплата рассчитывается именно за них.
В ноябре 2026 года стандартные тарифы некоторых моделей выглядят так.
| Модель | Миллион входных токенов | Миллион выходных токенов |
|---|---|---|
| GPT-6.1 Terra | 1 доллар | 5 долларов |
| GPT-6.1 Sol | 2 доллара | 10 долларов |
| Claude Haiku 5.5 | 0,10 доллара | 0,50 доллара |
| Claude Sonnet 5.5 | 2 доллара | 10 долларов |
Цены указаны для стандартного режима API без кэширования. Для Claude Haiku 5.5 действуют повышенные тарифы, если входной запрос превышает 100 тысяч токенов. Актуальные цены можно проверить в документации OpenAI и Anthropic.
Для расчёта затрат необходимо знать количество входных и выходных токенов, а также тарифы выбранной модели.
Формула выглядит так:
Стоимость = (входные токены × цена входа + выходные токены × цена выхода) ÷ 1 000 000.
Рассмотрим пример
Программист попросил GPT-6.1 Terra найти ошибку в коде. Запрос вместе с инструкциями занял 1000 входных токенов, а ответ модели — 500 выходных.
По стандартному тарифу миллион входных токенов стоит 1 доллар, а миллион выходных — 5 долларов.
Подставим значения в формулу:
(1000 × 1 + 500 × 5) ÷ 1 000 000 = 0,0035 доллара.
Таким образом, один запрос обойдётся в 0,35 цента. Если программист отправит более объёмный код или попросит подробный ответ, стоимость операции увеличится.
Расчёт приблизительный: мы не учитывали кэширование, дополнительные инструменты и другие особенности тарификации.
Некоторые функции API оплачиваются отдельно. Например, провайдер может взимать дополнительную плату за поиск в интернете, выполнение кода или хранение файлов.
Также стоимость зависит от режима обработки запросов. Например, при кэшировании повторно используемые входные данные могут обходиться дешевле. А для пакетной обработки запросов некоторые провайдеры предлагают сниженные тарифы.
В обычных чат-ботах оплата устроена иначе. Пользователь может работать с нейросетью бесплатно в пределах установленных ограничений или оформить подписку. В таком случае стоимость отдельных токенов обычно не рассчитывают для каждого сообщения.
Как сократить расход токенов
Чем больше текста нейросеть получает и генерирует, тем больше токенов расходуется. Однако сокращать запросы любой ценой не стоит: если модели не хватит информации, она может неправильно выполнить задачу, а на исправления потребуются дополнительные токены.
Рассмотрим основные способы уменьшить расход токенов без потери качества ответа.
Чётко формулируйте задачу
Укажите, что нужно сделать, какие данные использовать и каким должен быть результат. Необязательные подробности лучше убрать, но важные условия нужно сохранить.
Например, вместо длинного описания проекта и просьбы помочь с программой можно написать:
«Напиши функцию на Python 3.12, которая принимает список чисел и возвращает три наибольших значения. Если чисел меньше трёх, верни весь список».
Так модель сразу получит требования к программе, и вам с меньшей вероятностью придётся уточнять запрос.
Ограничивайте объём ответа
Если вам нужно краткое объяснение, несколько примеров или конкретный список, укажите это в запросе. Так модель не будет генерировать лишний текст.
Например, вместо «Расскажи, что такое API» можно написать:
«Объясни, что такое API, в трёх предложениях. Приведи один пример использования».
Это точно пригодится при работе через API, где каждый выходной токен влияет на стоимость запроса.
Передавайте только нужные фрагменты документов
Необязательно загружать большой файл целиком, если для решения задачи достаточно нескольких разделов.
Например, если нужно найти ошибку в программе, отправьте проблемную функцию, текст ошибки и связанные участки кода. Остальные файлы проекта можно не передавать, если они не влияют на работу функции.
Аналогично с документами: если требуется проверить условия расторжения договора, можно передать соответствующий раздел и связанные с ним положения, а не весь документ на сто страниц.
Сокращайте историю переписки
При работе через API предыдущие сообщения часто передаются модели вместе с новым запросом. Поэтому длинная переписка увеличивает количество входных токенов.
Например, если вы несколько часов разрабатывали с нейросетью приложение, необязательно каждый раз передавать весь диалог. Вместо этого можно сохранить краткую сводку:
«Разрабатываем телеграм-бота на Python 3.12. Используем Aiogram 3 и PostgreSQL. Авторизация готова, сейчас добавляем обработку платежей».
При этом важно сохранить принятые решения, требования и другие сведения, необходимые для продолжения работы.
Используйте кэширование при повторяющихся запросах
Некоторые API позволяют повторно использовать уже обработанные входные данные по сниженной цене. Это особенно полезно, если во многих запросах повторяются одни и те же инструкции или документы.
Например, если сервис ежедневно анализирует сотни отзывов покупателей по одинаковым правилам, эти правила можно передавать в неизменном виде. При поддержке кэширования повторяющаяся часть запроса может тарифицироваться дешевле.
Кэширование необязательно уменьшает количество токенов, но помогает снизить расходы на их обработку.
Главное о токенах
Мы разобрались, что такое токены, как нейросети используют их для обработки информации и от чего зависит их количество. Повторим главное.
- Токены — это единицы информации, с которыми работают нейросети. При обработке текста токеном может быть целое слово, часть слова или знак препинания. Изображения, аудио и видео тоже могут преобразовываться в токены, но другими способами.
- Текст разбивает на токены специальная программа — токенизатор. У разных моделей словари и правила разбиения отличаются. Поэтому количество токенов зависит от токенизатора, языка и особенностей написания текста.
- Языковая модель генерирует ответ токен за токеном. На каждом шаге она оценивает возможные продолжения с учётом запроса и предыдущего текста, а затем выбирает следующий токен.
- Контекстное окно ограничивает объём информации, с которой может работать модель. В нём учитываются запрос, инструкции, переданная история переписки и генерируемый ответ. При этом длина ответа может быть ограничена отдельно.
- Количество токенов влияет на стоимость работы через API. Входные и выходные токены обычно оплачиваются по разным тарифам. Предварительный расход можно оценить с помощью счётчика токенов, а фактический — посмотреть в данных API.
- Сократить расходы помогают чёткие запросы и управление контекстом. Передавайте только необходимые материалы, задавайте нужный объём ответа и убирайте из истории переписки устаревшие сведения. При этом не стоит сокращать инструкции настолько, чтобы модели не хватало информации для выполнения задачи.