Все
 Истории
 Дизайн
 Код
 Геймдев
 Бизнес
 Маркетинг
 Управление
 Кино
 Музыка
 Проектная фотография
 Развитие
 Здоровье
 Деньги
 Образование
 EdTech
 Корп. обучение
 Блог Skillbox
 Глоссарий
 Спецпроекты
 Профориентация

Что такое RAG и как он работает
Собираем собственный проект с RAG, который поможет в изучении программирования.
Языковые модели умеют работать с большими объёмами текста, но не всегда располагают информацией, которая нужна для конкретной задачи. Например, они не знают содержимого внутренней документации компании, закрытой базы знаний или пользовательских файлов.
Один из способов дать модели доступ к таким данным — использовать RAG. Этот подход применяют в корпоративных ассистентах, ИИ-агентах, поиске по документам, службах поддержки и других системах, которым нужно отвечать с опорой на конкретные источники.
В этой статье мы разберём, что такое RAG, как устроена такая система и где её используют. А в практической части соберём простой RAG-проект и посмотрим, как его основные компоненты работают вместе.
Содержание
- Что такое RAG
- Где он используется
- Архитектура и компоненты RAG
- Как ИИ-агенты взаимодействуют с RAG
- Создаём проект с RAG-системой
- Как оценить качество работы
- Что учить дальше
Что такое RAG и чем он отличается от LLM
RAG (Retrieval-Augmented Generation) — это подход к созданию ИИ-систем, при котором языковая модель перед генерацией ответа получает дополнительную информацию из внешних источников.
Обычная языковая модель формирует ответ на основе знаний, полученных во время обучения, и данных, которые переданы ей в текущем контексте. В RAG-системе к этому добавляется отдельный этап поиска: система сначала находит информацию, связанную с запросом пользователя, а затем передаёт её модели вместе с самим запросом.
Источником данных могут быть корпоративные документы, база знаний, пользовательские файлы, база данных или другие доступные системе источники.
Например, сотрудник спрашивает корпоративного ИИ-ассистента о правилах оформления отпуска. LLM без дополнительного контекста сможет ответить только на основе общих знаний и информации из запроса. RAG-система сначала найдёт нужный раздел внутреннего регламента и передаст его модели, а та сформирует ответ с учётом правил конкретной компании.
При этом RAG сам по себе не является нейросетью или отдельной языковой моделью. Это архитектурный подход, который объединяет несколько компонентов: источник данных, механизм поиска и LLM. Поиск отвечает за получение релевантной информации, а языковая модель использует её как контекст для генерации ответа.
Поэтому сравнивать RAG и LLM напрямую не совсем корректно. LLM — это модель, которая генерирует текст, а RAG — способ организовать работу системы вокруг такой модели и дополнить её внешними данными.
Где используют RAG
RAG используют в системах, которым нужно отвечать с опорой на конкретные внешние данные — например, внутренние документы компании, инструкции, договоры, техническая документация, базы данных и другие источники.
Корпоративные базы знаний. Сотрудник задаёт вопрос обычным языком, а система находит нужную информацию во внутренних документах и формирует ответ на её основе. Допустим, так можно искать правила оформления отпуска, инструкции для новых сотрудников или внутренние регламенты.
Техническая поддержка. ИИ-помощник может искать информацию в документации по продукту, инструкциях и материалах службы поддержки. Это позволяет автоматически отвечать на типовые вопросы пользователей, а сложные обращения передавать специалистам.
Работа с документами. RAG применяют для поиска и анализа информации в договорах, отчётах, технических спецификациях и больших архивах документов. Например, пользователь может спросить об условиях расторжения договора, а система найдёт соответствующие пункты и подготовит ответ на их основе. Именно такое решение мы реализуем в практической части статьи.
При использовании RAG в медицине, юриспруденции и других сферах, где цена ошибки высока, ответы системы требуют дополнительной проверки специалистом. Наличие источника само по себе не гарантирует правильности ответа: документ может быть устаревшим, поиск — выбрать неподходящий фрагмент, а модель — неверно его интерпретировать.
Как устроена RAG
Архитектура RAG зависит от задачи, но базовая схема обычно одна и та же. Система подготавливает данные, ищет в них информацию по запросу пользователя, а затем передаёт найденные фрагменты языковой модели для генерации ответа. Рассмотрим основные этапы.
Источник данных и их подготовка
Источниками могут быть документы, базы данных, корпоративные сервисы и другие системы. Перед поиском данные обычно очищают и разбивают на небольшие смысловые фрагменты — чанки (chunks).
Размер чанков влияет на качество поиска. Слишком большой фрагмент может содержать много лишней информации, а слишком маленький — потерять контекст. Поэтому способ разбивки обычно подбирают под конкретные данные и задачу.
К чанкам также можно добавить метаданные: название документа, раздел, номер страницы или ссылку. Они помогают фильтровать результаты и показывать пользователю источники ответа.
Поиск нужной информации
Один из основных способов поиска в RAG — векторный поиск. Для него текст преобразуют в эмбеддинги (embeddings) — числовые представления, которые позволяют сравнивать фрагменты по смыслу.
Например, запрос «Сервер не отвечает» можно сопоставить с фрагментом документации «Не удаётся установить соединение с сервером», хотя точные формулировки отличаются друг от друга.
Подходящие фрагменты выбирает ретривер (retriever). В некоторых системах векторный поиск объединяют с полнотекстовым, чтобы учитывать и смысл запроса, и точные совпадения — например, номера ошибок или идентификаторы. Такой подход называют гибридным поиском.
Найденные результаты также можно дополнительно отсортировать с помощью реранкинга (reranking), чтобы выбрать наиболее релевантные фрагменты.
Генерация ответа
После поиска система добавляет найденные фрагменты к запросу пользователя и передаёт их языковой модели. LLM использует этот контекст для подготовки ответа.
Если вместе с фрагментами сохранены метаданные, приложение может показать документы, страницы или ссылки, на которых основан ответ.
В более сложных RAG-системах также используют контроль доступа, фильтрацию запросов и инструменты мониторинга. Они помогают ограничивать доступ к данным и разбираться, почему система выдала неправильный ответ.
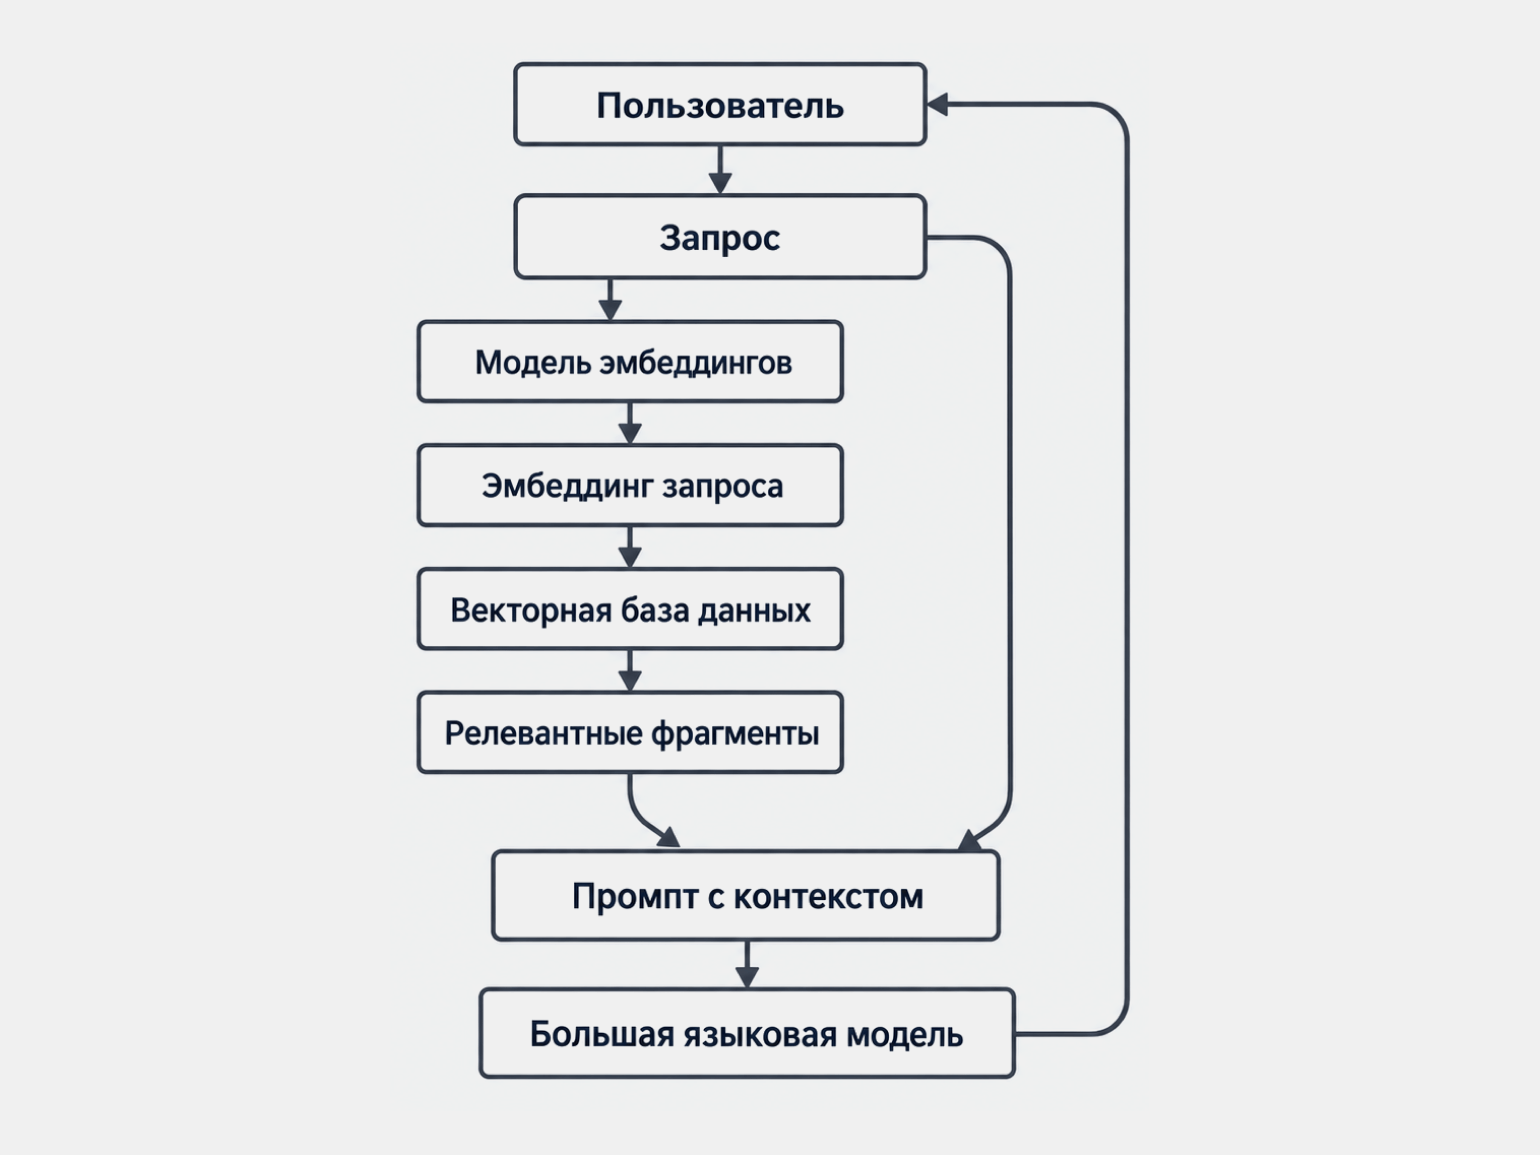
Изображение: ChatGPT / Skillbox Media
Как ИИ-агенты взаимодействуют с RAG
В обычной RAG-системе последовательность действий заранее задаёт разработчик: получить запрос, найти подходящие фрагменты в базе знаний и передать их языковой модели.
В системе с ИИ-агентом часть этих решений принимает сама модель. Агент может определить, нужен ли поиск вообще, выбрать подходящий источник, уточнить запрос и решить, что делать с найденной информацией дальше.
RAG в такой системе становится одним из инструментов агента наряду с API, базами данных и другими сервисами. Такой подход называют Agentic RAG, или агентным RAG.
Например, новый сотрудник спрашивает корпоративного ассистента, какие документы нужно принести в первый рабочий день. Обычная RAG-система найдёт инструкции по онбордингу и сформирует ответ на их основе.
ИИ-агент может пойти дальше. Сначала он найдёт общие правила через RAG, затем обратится к HR-системе через API и проверит должность сотрудника, подразделение и уже оформленные документы. После этого объединит данные и подготовит персональный список действий.
Если информации окажется недостаточно, агент сможет изменить поисковый запрос и снова обратиться к базе знаний. Например, отдельно найти инструкции для конкретного подразделения или должности.
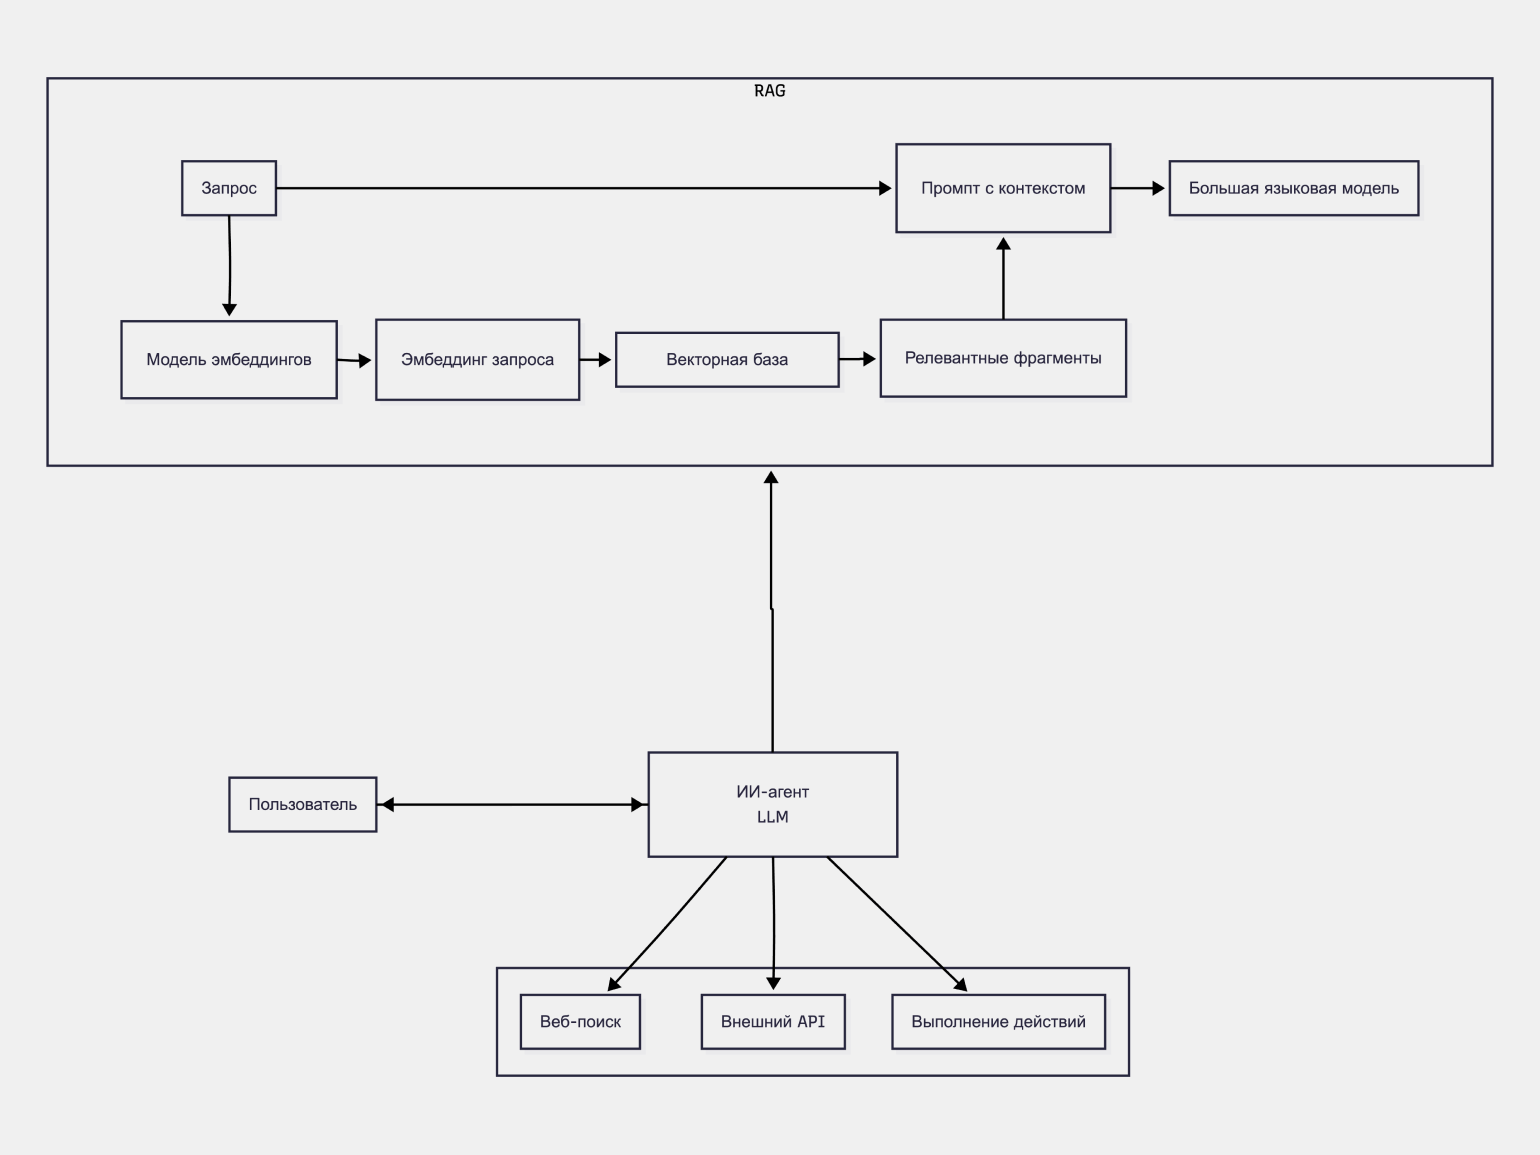
Изображение: Mermaid.ai
Агенту также можно подключить память, чтобы сохранять информацию между действиями или диалогами. Например, корпоративный ассистент сможет учитывать, какие этапы онбординга сотрудник уже прошёл, и не предлагать их повторно.
Другой типичный сценарий — техническая поддержка. RAG может найти инструкцию по решению проблемы, а агент — дополнительно проверить статус заказа через API, получить сведения о платеже или создать обращение специалисту. В результате система не только отвечает на вопросы, но и выполняет связанные с ними действия.
Читайте также:
Создаём проект с RAG-системой
Перед разработкой RAG нужно определить, какую задачу будет решать система, где будут храниться данные, как часто их нужно обновлять и нужно ли показывать пользователю ссылки на источники.
В качестве примера создадим простой прототип ИИ-помощника по документации Python. Работать будем в бесплатной облачной среде Google Colab.
Для базы знаний возьмём несколько страниц официальной документации Python: о модулях, структурах данных и работе с интерпретатором.
Скопируйте текст каждой страницы, вставьте его в текстовый редактор и сохраните в отдельный TXT-файл. Эти файлы мы загрузим в RAG-систему с помощью Python.
Шаг 1: готовим окружение и документы
В Google Colab создайте новый ноутбук с помощью кнопки New Notebook. Затем откройте раздел Files — значок папки на боковой панели — и загрузите три подготовленных TXT-файла. Colab сохранит их в папке /content.
Для работы RAG-системы установите несколько библиотек:
- Sentence-transformers — для создания эмбеддингов;
- Transformers и Accelerate — для запуска языковой модели;
- Scikit-learn — для расчёта сходства между вектором запроса и векторами чанков.
Для этого в Google Colab введите команду:
!pip install -q -U sentence-transformers transformers accelerate scikit-learn
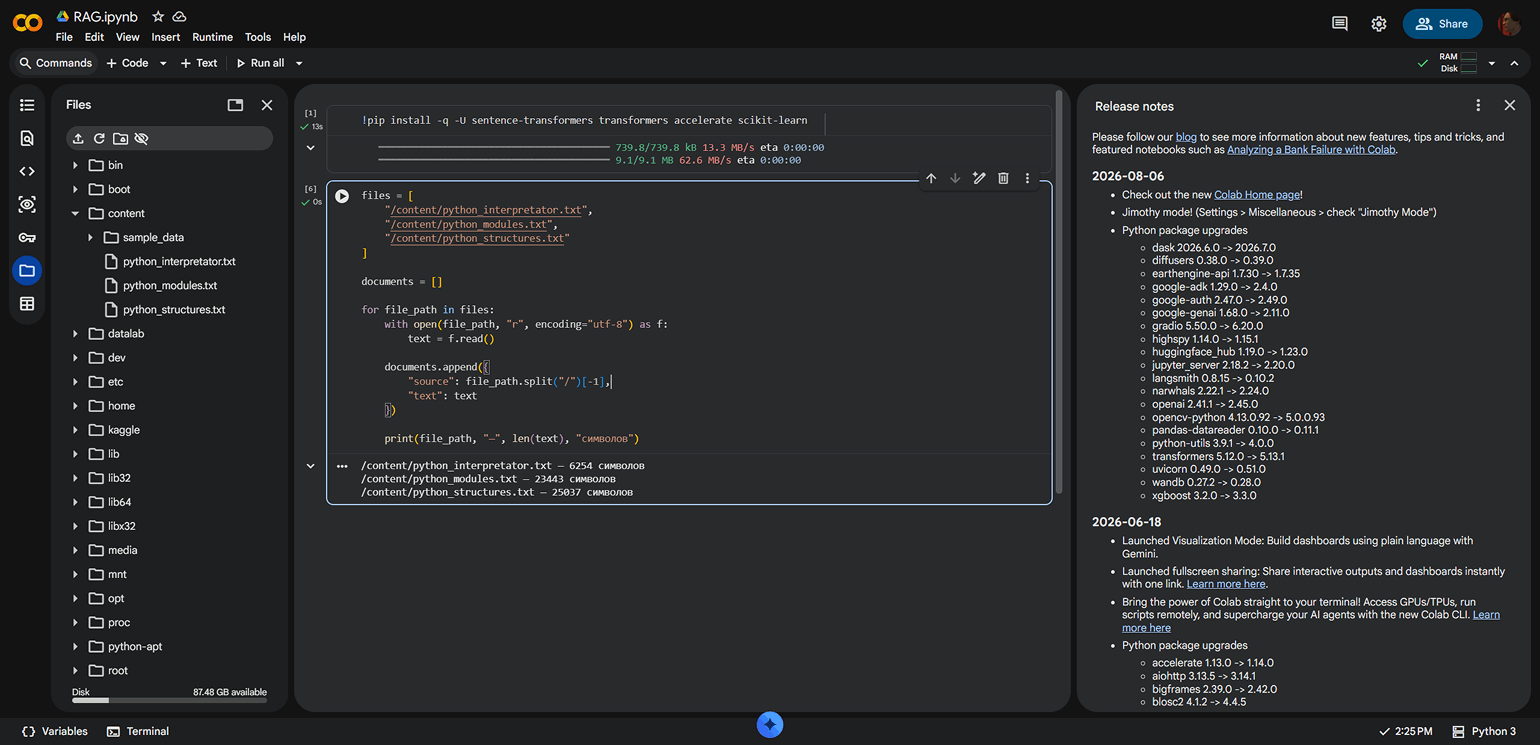
Теперь проверьте, доступны ли загруженные файлы и удаётся ли их прочитать. Сохраните пути к файлам в переменной files, а содержимое документов — в списке documents. Для этого нажмите + Code и добавьте код:
files = [
    "/content/python_interpretator.txt",
    "/content/python_modules.txt",
    "/content/python_structures.txt"
]

documents = []

for file_path in files:
    with open(file_path, "r", encoding="utf-8") as f:
        text = f.read()

    documents.append({
        "source": file_path.split("/")[-1],
        "text": text
    })

    print(file_path, "--", len(text), "символов")
После выполнения кода Colab выведет название каждого файла и количество символов в нём. Если все три файла отображаются без ошибок, переходите к очистке текста.
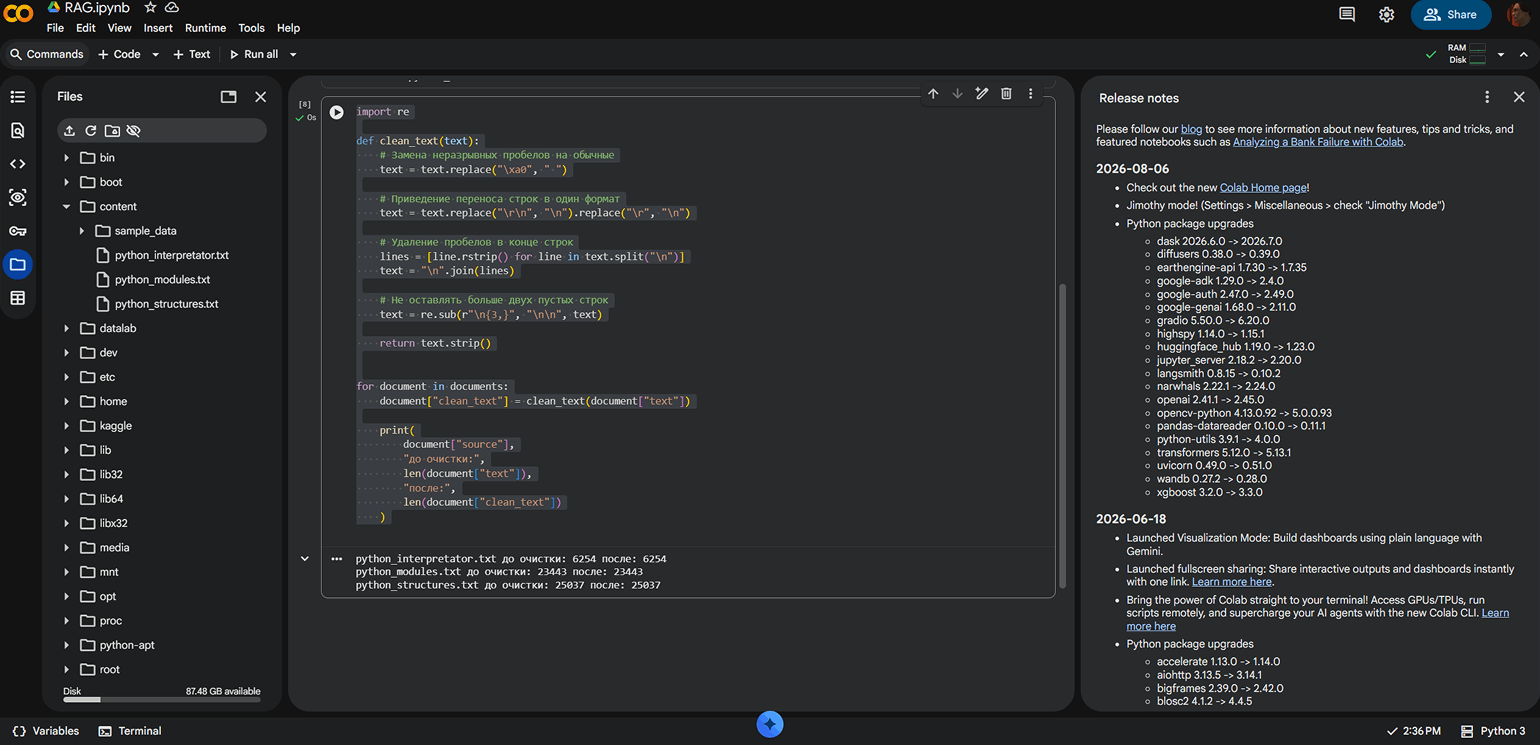
Поскольку в документации Python встречаются примеры кода, очищайте текст аккуратно, чтобы не удалить значимые отступы. Приведите переносы строк к единому формату, уберите пробелы в конце строк и сократите повторяющиеся пустые строки. Для этого используйте код:
import re

def clean_text(text):
    # Замена неразрывных пробелов на обычные
    text = text.replace("\xa0", " ")

    # Приведение переноса строк в один формат
    text = text.replace("\r\n", "\n").replace("\r", "\n")

    # Удаление пробелов в конце строк
    lines = [line.rstrip() for line in text.split("\n")]
    text = "\n".join(lines)

    # Не оставлять больше двух пустых строк
    text = re.sub(r"\n{3,}", "\n\n", text)

    return text.strip()


for document in documents:
    document["clean_text"] = clean_text(document["text"])

    print(
        document["source"],
        "до очистки:",
        len(document["text"]),
        "после:",
        len(document["clean_text"])
    )
Не переживайте, если после очистки объём текста почти не изменился. Это нормально: значит, в исходных файлах не было лишних пробелов, повторяющихся пустых строк и другого технического мусора.
Главная задача этого этапа — привести документы к единому формату перед чанкингом.
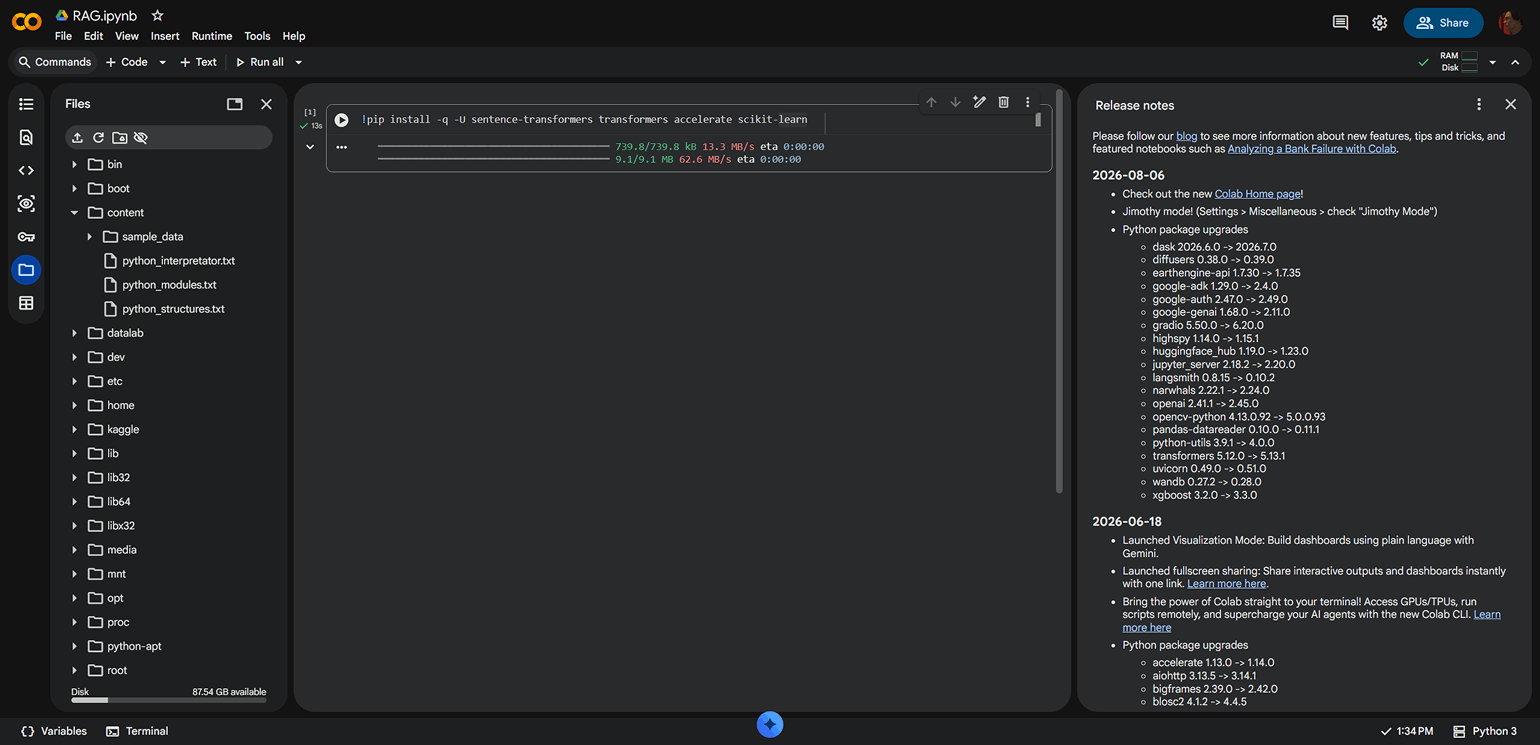
Скриншот: Google Colab / Google / Skillbox Media
Скриншот: Google Colab / Google / Skillbox Media
Скриншот: Google Colab / Google / Skillbox Media
Теперь добавьте к документам метаданные — дополнительную информацию, которая будет храниться вместе с текстом. В нашем случае это название документа, его тема и ссылка на оригинал.
Для этого используйте следующий код:
metadata = {
    "python_interpretator.txt": {
        "title": "Использование интерпретатора Python",
        "topic": "Интерпретатор",
        "url": "https://docs.python.org/ru/3.14/tutorial/interpreter.html"
    },

    "python_modules.txt": {
        "title": "Модули Python",
        "topic": "Модули",
        "url": "https://docs.python.org/ru/3.14/tutorial/modules.html"
    },

    "python_structures.txt": {
        "title": "Структуры данных Python",
        "topic": "Структуры данных",
        "url": "https://docs.python.org/ru/3.14/tutorial/datastructures.html"
    }
}

for document in documents:
    document.update(metadata[document["source"]])

print("Метаданные добавлены.")
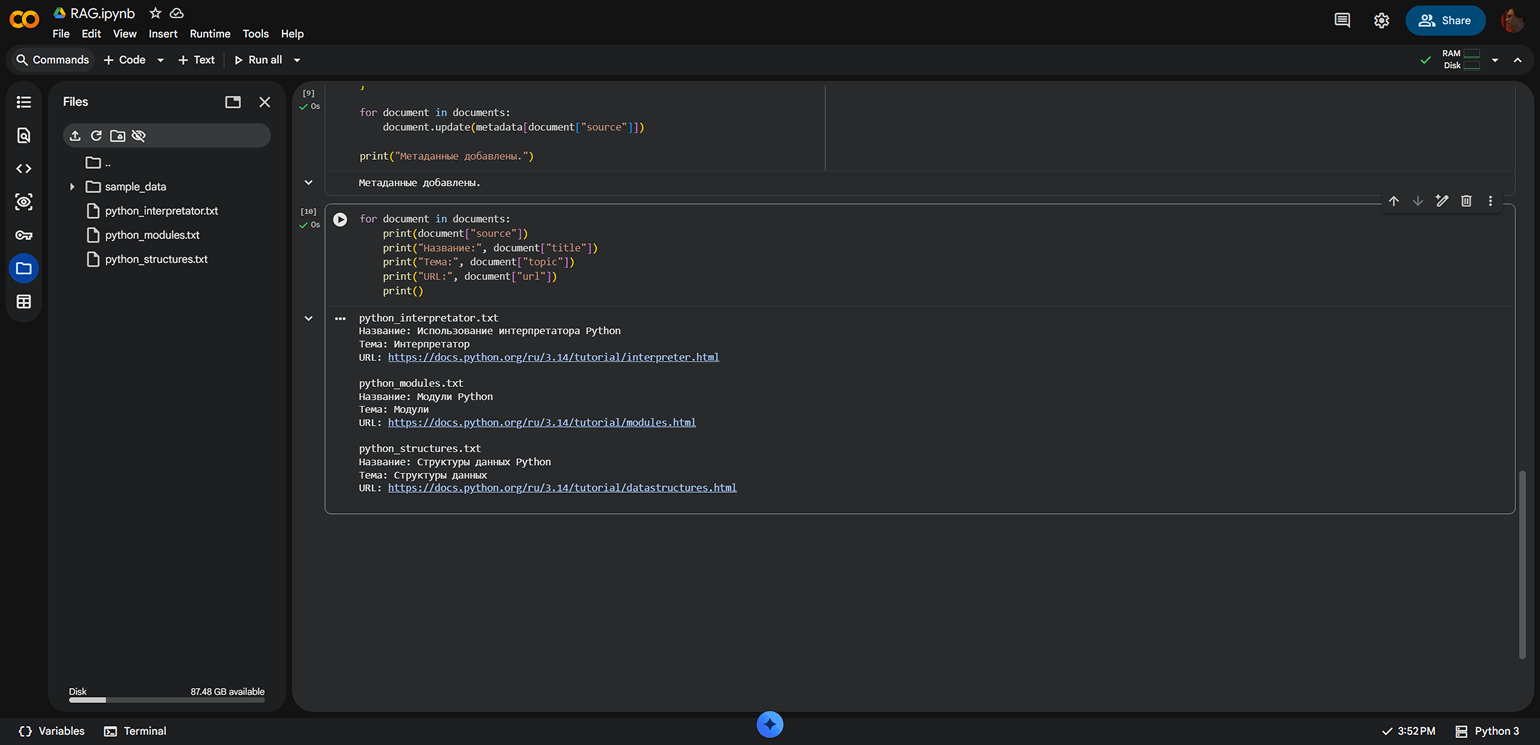
После этого запустите проверку работы метаданных:
for document in documents:
    print(document["source"])
    print("Название:", document["title"])
    print("Тема:", document["topic"])
    print("URL:", document["url"])
    print()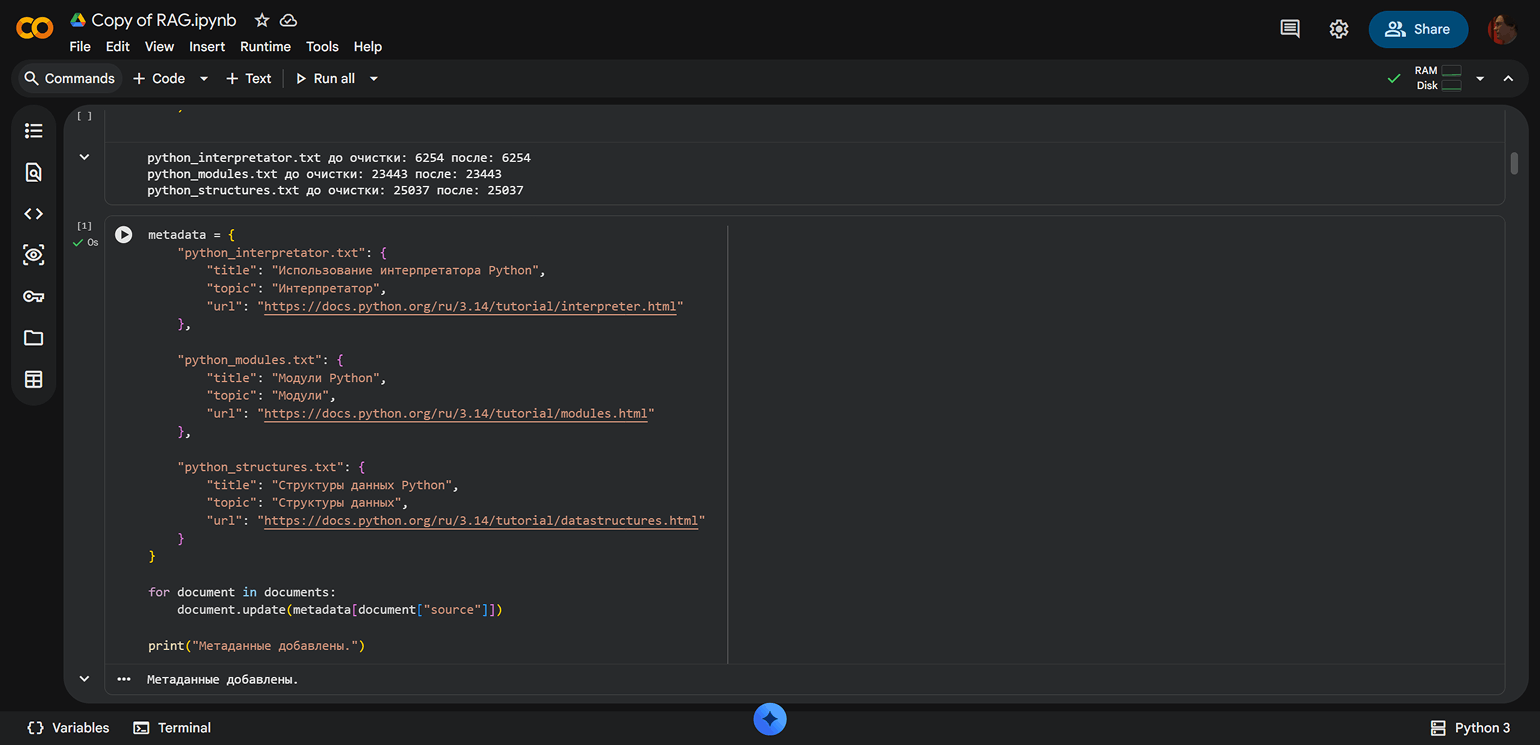
Скриншот: Google Colab / Google / Skillbox Media
Скриншот: Google Colab / Google / Skillbox Media
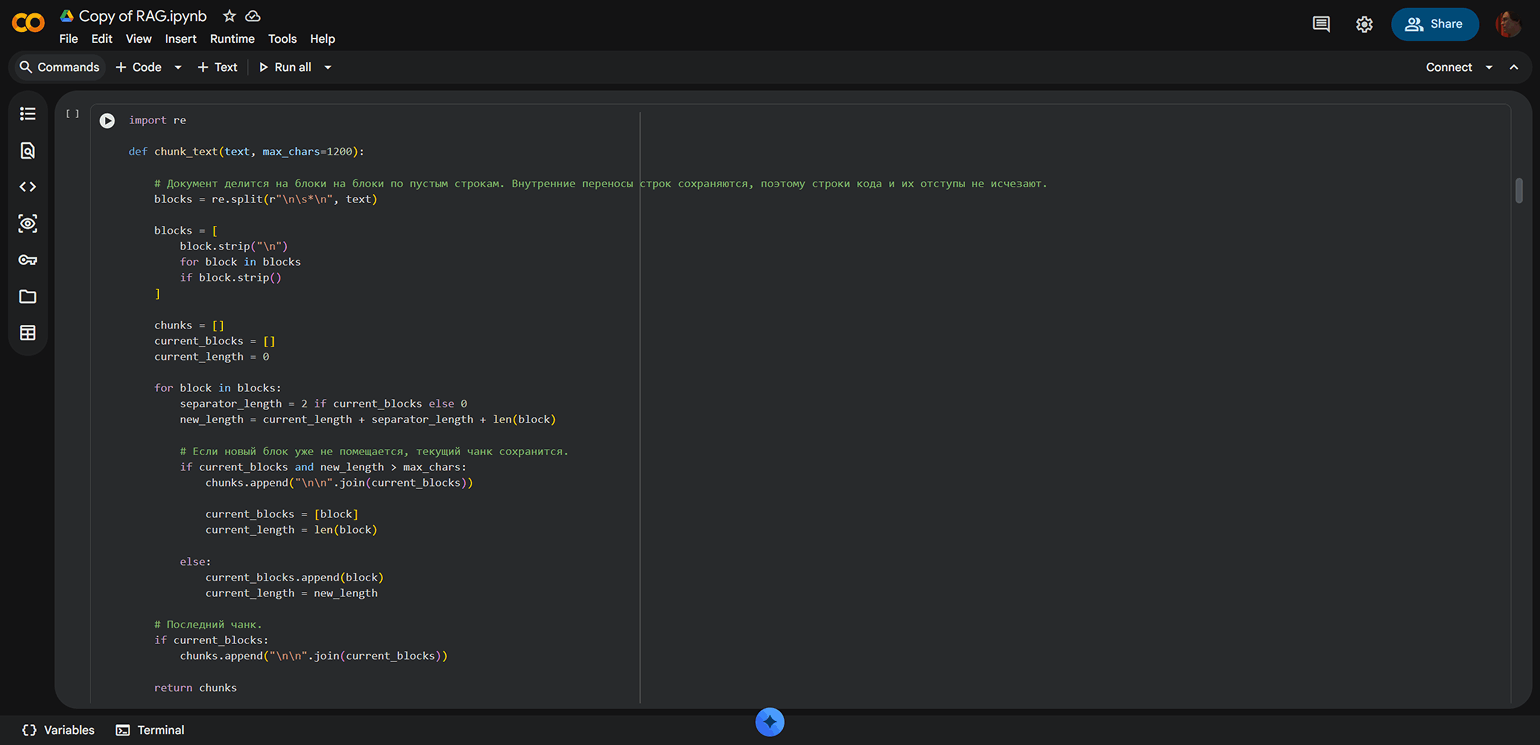
Приступим к чанкингу — разбиению больших документов на небольшие фрагменты. В нашем случае важно не разрывать строки кода и сохранять их отступы.
Сначала разделите текст по пустым строкам на отдельные блоки, а затем объедините соседние блоки в чанки размером примерно до 1200 символов. Значение 1200 здесь используется только для примера. В реальной RAG-системе размер чанков подбирают под конкретные документы и проверяют на тестовых запросах.
Начнём с создания функции для чанкинга:
import re
def chunk_text(text, max_chars=1200):

    # Документ делится на блоки по пустым строкам. Внутренние переносы строк сохраняются, поэтому строки кода и их отступы не исчезают
    blocks = re.split(r"\n\s*\n", text)

    blocks = [
        block.strip("\n")
        for block in blocks
        if block.strip()
    ]

    chunks = []
    current_blocks = []
    current_length = 0

    for block in blocks:
        separator_length = 2 if current_blocks else 0
        new_length = current_length + separator_length + len(block)

        # Если новый блок уже не помещается, текущий чанк сохранится
        if current_blocks and new_length > max_chars:
            chunks.append("\n\n".join(current_blocks))

            current_blocks = [block]
            current_length = len(block)

        else:
            current_blocks.append(block)
            current_length = new_length

    # Последний чанк
    if current_blocks:
        chunks.append("\n\n".join(current_blocks))

    return chunks
Теперь примените функцию ко всем трём документам:
chunks = []

for document in documents:

    document_chunks = chunk_text(
        document["clean_text"],
        max_chars=1200
    )

    for chunk_id, text in enumerate(document_chunks):

        chunks.append({
            "source": document["source"],
            "title": document["title"],
            "topic": document["topic"],
            "url": document["url"],

            # Это уже метаданные конкретного чанка
            "chunk_id": chunk_id,

            # Сам текст чанка
            "text": text
        })

    print(
        document["source"],
        "→",
        len(document_chunks),
        "чанков"
    )

print("\nВсего создано чанков:", len(chunks))
Код создаст чанки для каждого документа, перенесёт в них общие метаданные и присвоит каждому фрагменту свой номер.
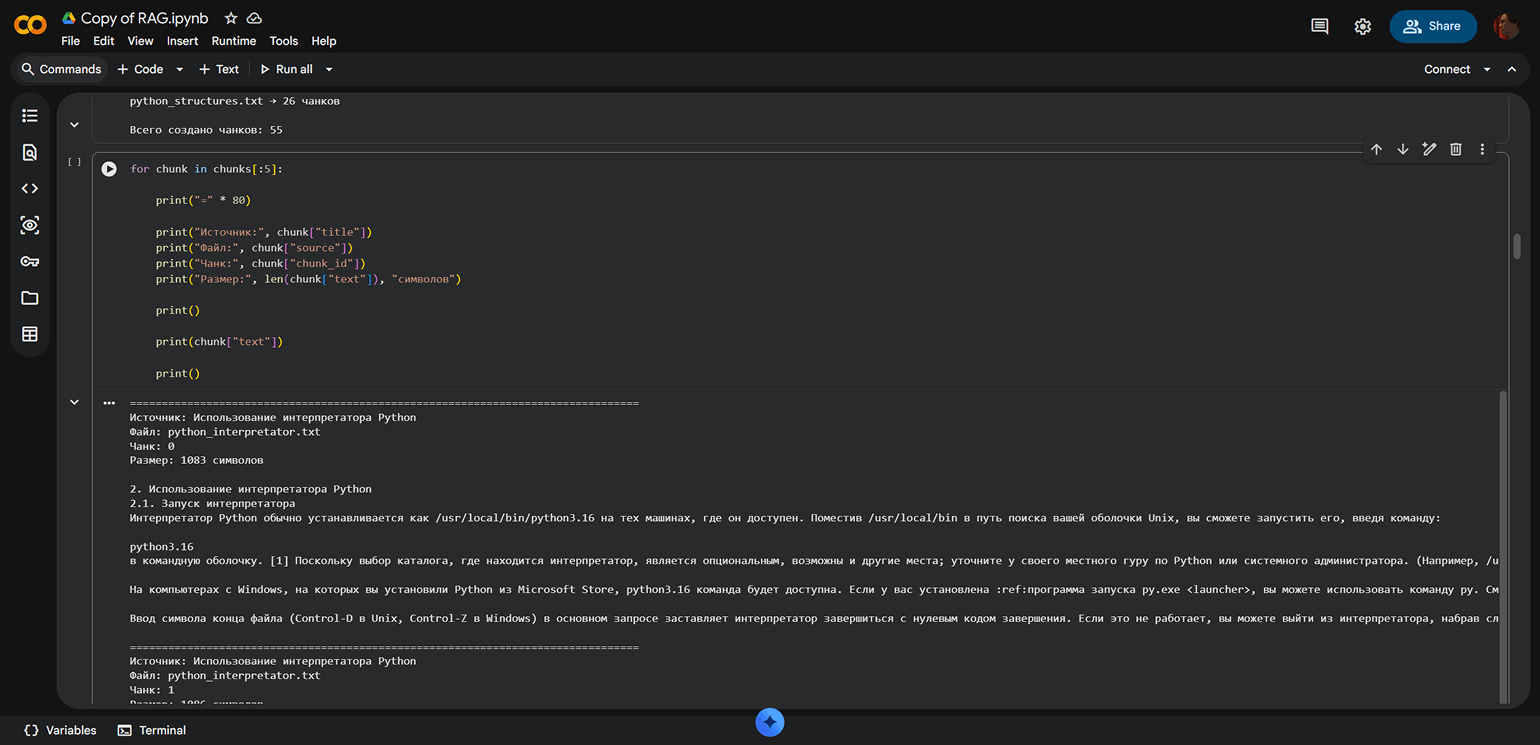
Теперь проверьте первые несколько чанков:
for chunk in chunks[:5]:

    print("=" * 80)

    print("Источник:", chunk["title"])
    print("Файл:", chunk["source"])
    print("Чанк:", chunk["chunk_id"])
    print("Размер:", len(chunk["text"]), "символов")

    print()

    print(chunk["text"])

    print()
После выполнения Colab выведет первые пять чанков целиком. Проверьте, не обрываются ли абзацы, сохранились ли отступы в примерах кода и достаточно ли в каждом фрагменте контекста для понимания текста.
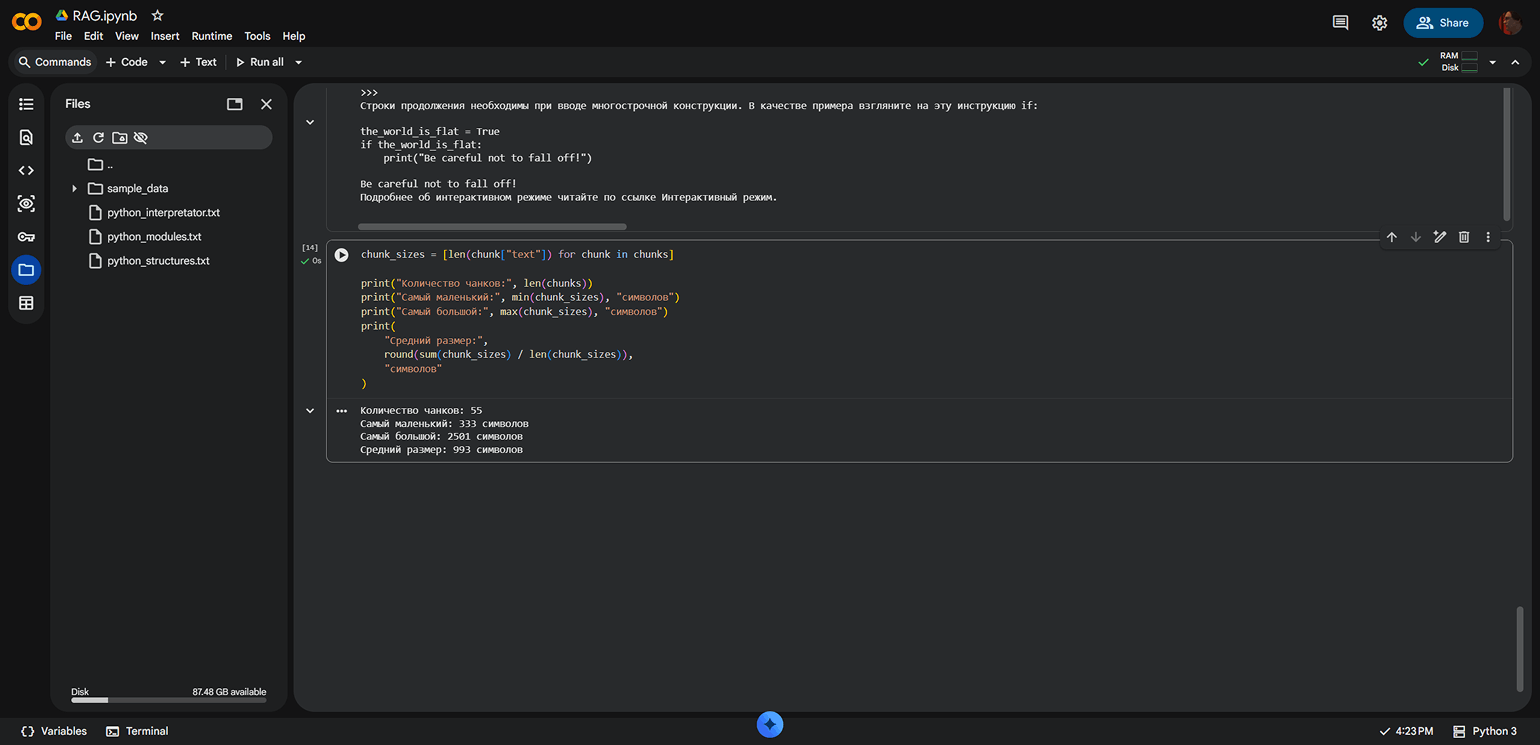
Дополнительно проверьте размеры чанков:
chunk_sizes = [len(chunk["text"]) for chunk in chunks]

print("Количество чанков:", len(chunks))
print("Самый маленький:", min(chunk_sizes), "символов")
print("Самый большой:", max(chunk_sizes), "символов")
print(
    "Средний размер:",
    round(sum(chunk_sizes) / len(chunk_sizes)),
    "символов"
)
По результатам можно заметить, что некоторые чанки превышают 1200 символов. Это связано с особенностями работы функции: она использует этот порог только при объединении соседних блоков и не делит блок, если он сам по себе оказался больше заданного размера.
Такой подход помогает сохранить целостность абзацев и примеров кода, даже если отдельные чанки получаются крупнее остальных.
Скриншот: Google Colab / Google / Skillbox Media
Скриншот: Google Colab / Google / Skillbox Media
Скриншот: Google Colab / Google / Skillbox Media
Шаг 2: создаём эмбеддинги и тестируем поиск
Теперь преобразуйте текст каждого чанка в эмбеддинг. Для этого загрузите модель с поддержкой русского языка, например paraphrase-multilingual-MiniLM-L12-v2. Она не генерирует текст, а переводит его в числовые векторы, которые можно сравнивать между собой при семантическом поиске.
Для загрузки модели используйте код:
from sentence_transformers import SentenceTransformer

embedding_model = SentenceTransformer(
    "sentence-transformers/paraphrase-multilingual-MiniLM-L12-v2"
)
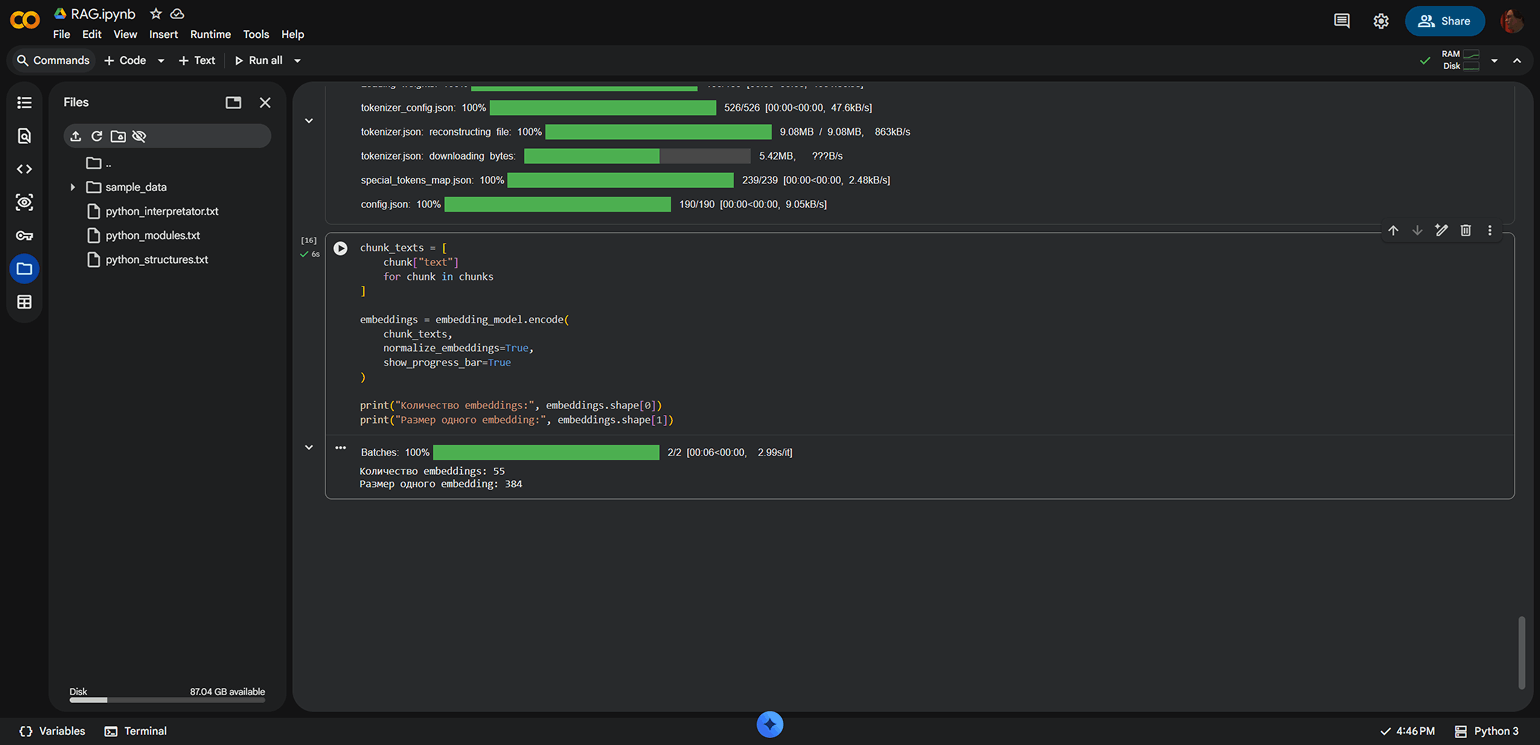
Теперь создайте эмбеддинги для всех чанков:
chunk_texts = [
    chunk["text"]
    for chunk in chunks
]

embeddings = embedding_model.encode(
    chunk_texts,
    normalize_embeddings=True,
    show_progress_bar=True
)

print("Количество embeddings:", embeddings.shape[0])
print("Размер одного embedding:", embeddings.shape[1])
После выполнения кода Colab выведет количество созданных эмбеддингов и размер одного вектора.
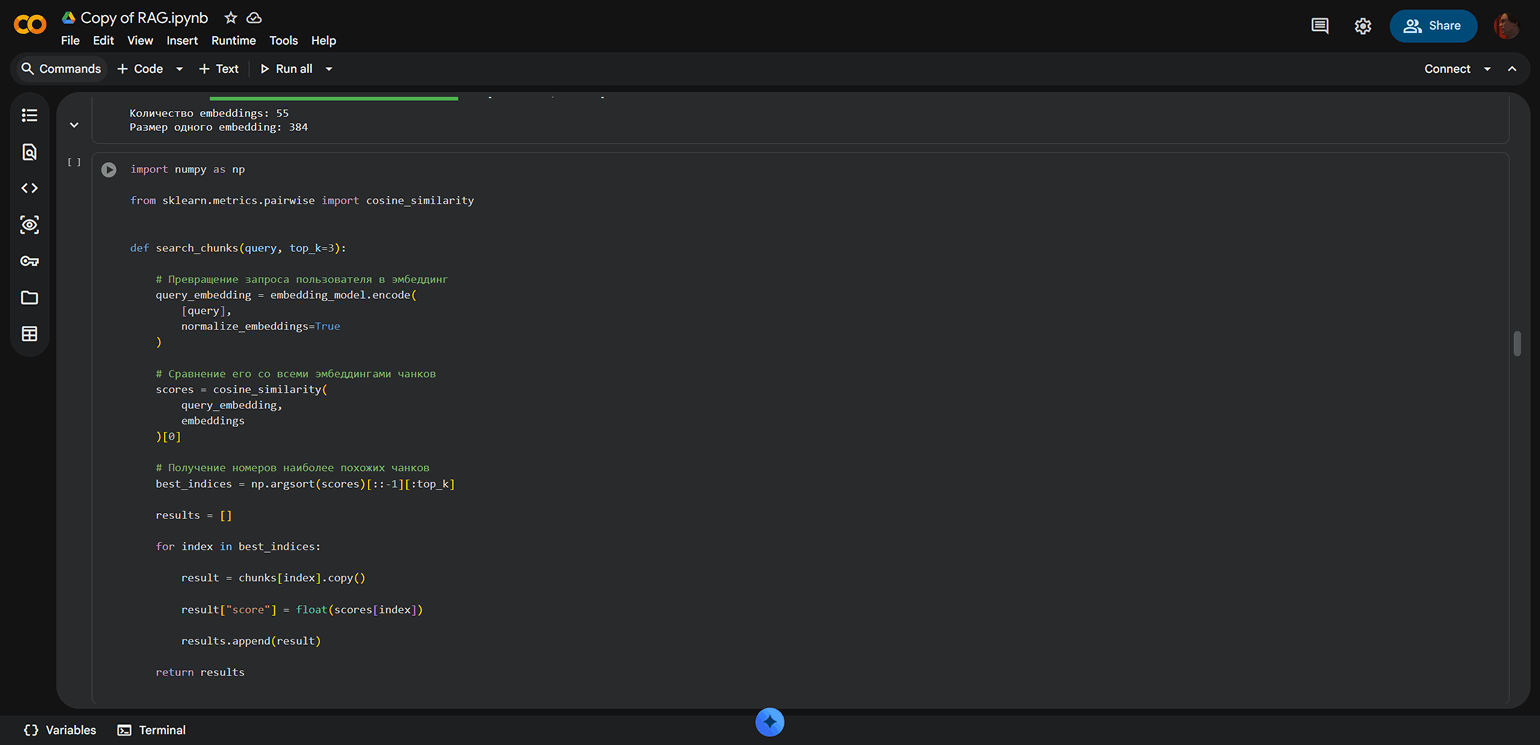
Теперь создайте функцию поиска. Она будет преобразовывать запрос пользователя в эмбеддинг, сравнивать его с эмбеддингами чанков и возвращать наиболее похожие фрагменты:
import numpy as np

from sklearn.metrics.pairwise import cosine_similarity


def search_chunks(query, top_k=3):

    # Превращение запроса пользователя в эмбеддинг
    query_embedding = embedding_model.encode(
        [query],
        normalize_embeddings=True
    )

    # Сравнение его со всеми эмбеддингами чанков
    scores = cosine_similarity(
        query_embedding,
        embeddings
    )[0]

    # Получение номеров наиболее похожих чанков
    best_indices = np.argsort(scores)[::-1][:top_k]

    results = []

    for index in best_indices:

        result = chunks[index].copy()

        result["score"] = float(scores[index])

        results.append(result)

    return results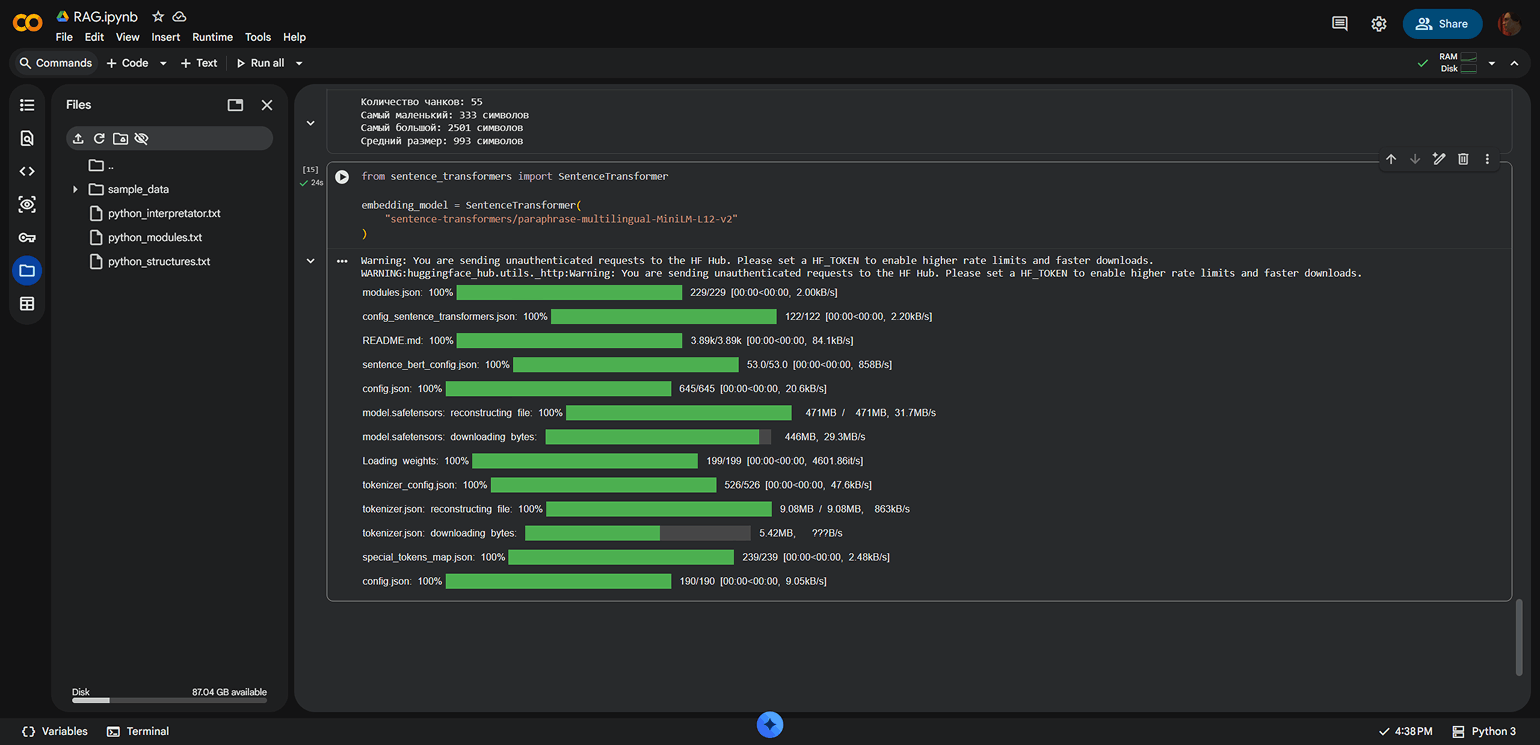
Скриншот: Google Colab / Google / Skillbox Media
Скриншот: Google Colab / Google / Skillbox Media
Скриншот: Google Colab / Google / Skillbox Media
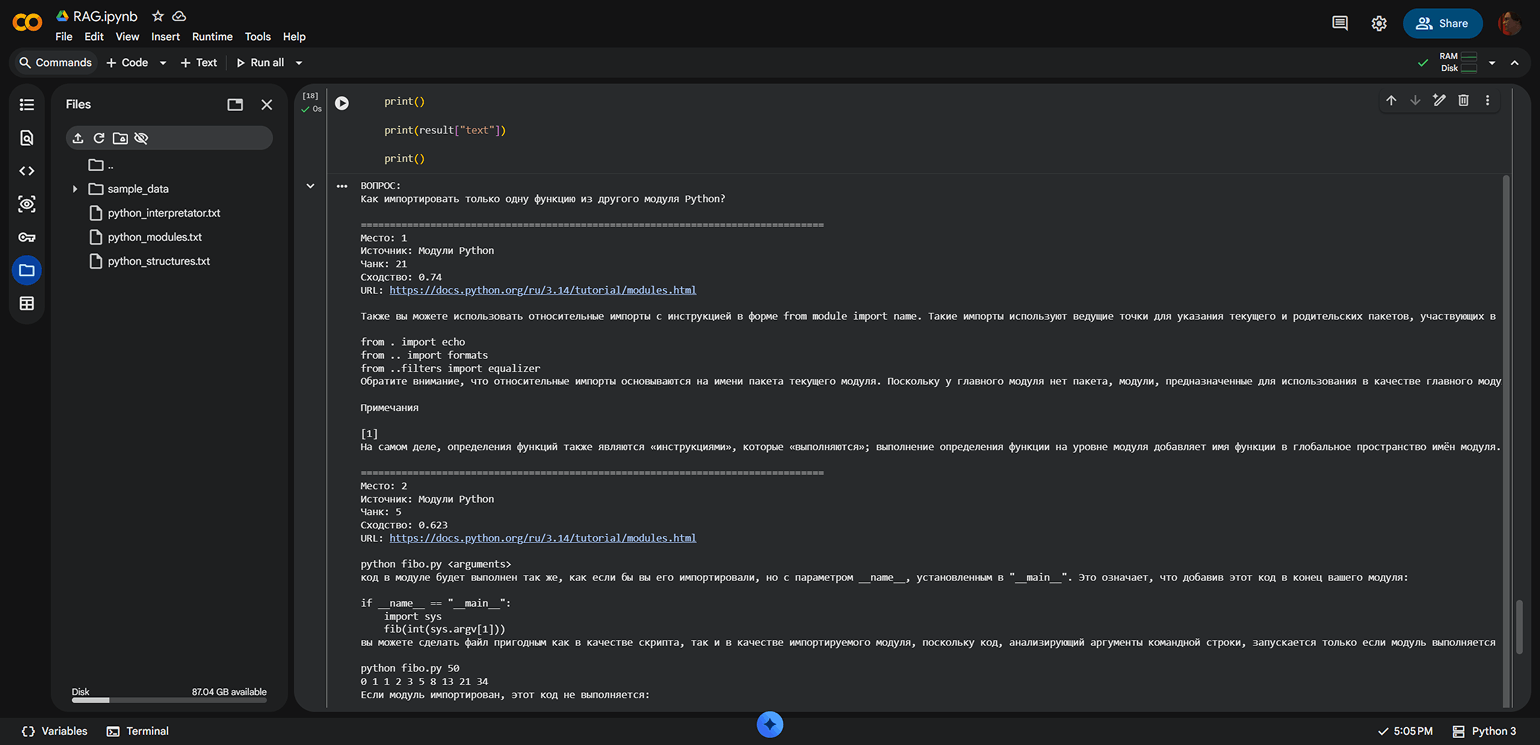
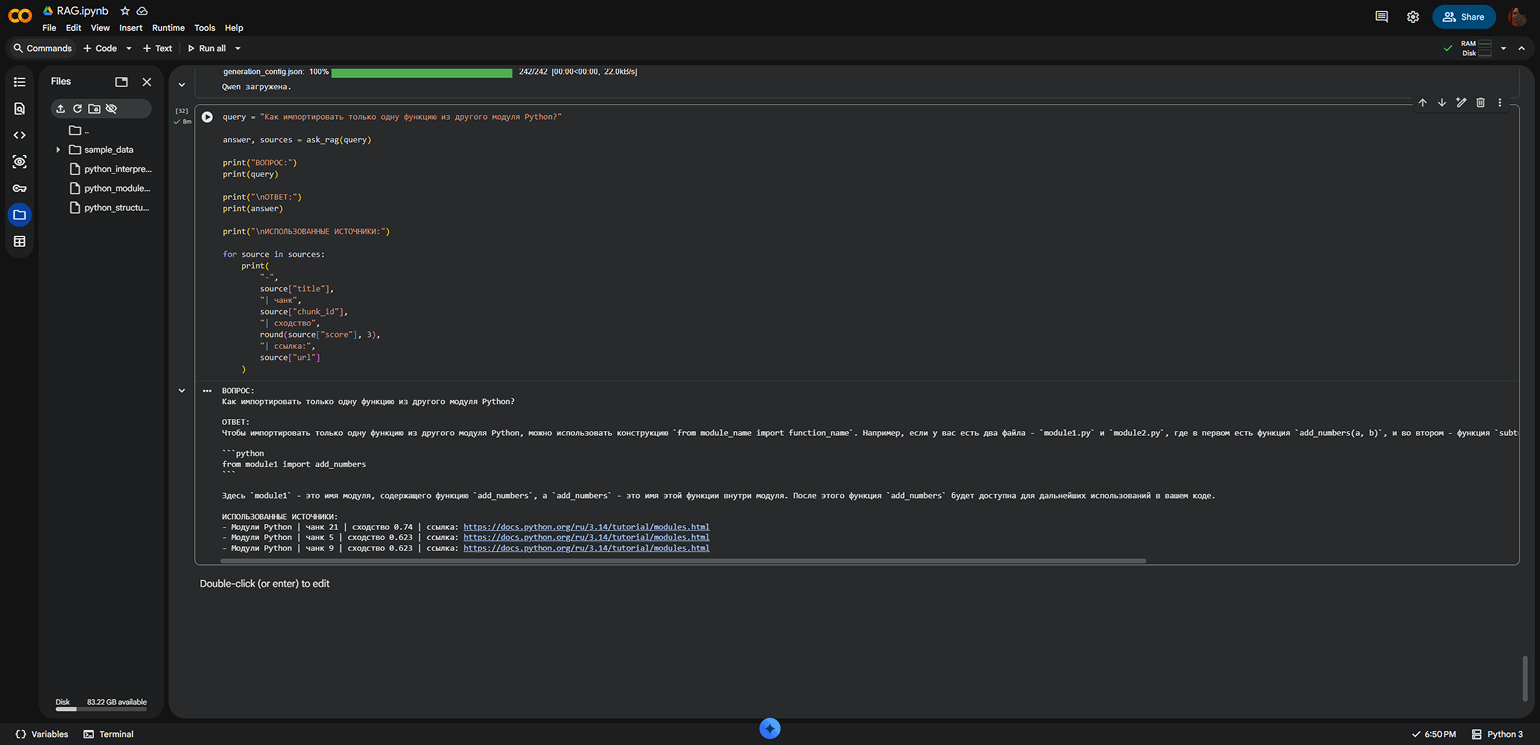
На этом этапе уже можно проверить поисковую часть RAG без языковой модели. Например, задайте вопрос по теме модулей:
query = "Как импортировать только одну функцию из другого модуля Python?"

results = search_chunks(
    query,
    top_k=3
)

print("ВОПРОС:")
print(query)
print()

for number, result in enumerate(results, start=1):

    print("=" * 80)

    print("Место:", number)
    print("Источник:", result["title"])
    print("Чанк:", result["chunk_id"])
    print(
        "Сходство:",
        round(result["score"], 3)
    )
    print("URL:", result["url"])

    print()

    print(result["text"])

    print()
Система выведет три наиболее подходящих чанка, их источники, номера и коэффициент сходства с запросом.
Скриншот: Google Colab / Google / Skillbox Media
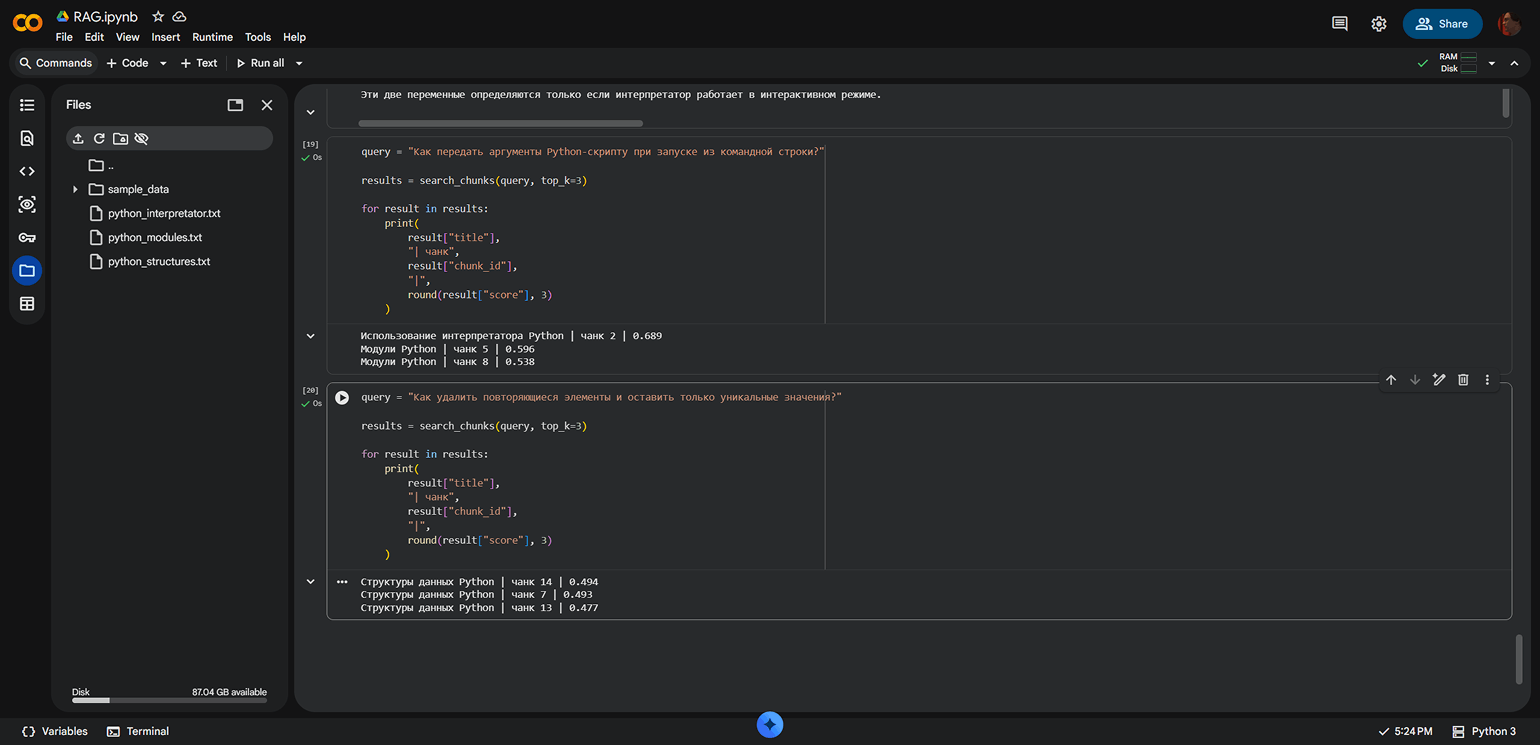
Теперь проверьте поиск на других темах из документации. Чтобы не выводить содержимое чанков целиком, можно использовать сокращённый вариант:
 query = "Как передать аргументы Python-скрипту при запуске из командной строки?"

results = search_chunks(query, top_k=3)

for result in results:
    print(
        result["title"],
        "| чанк",
        result["chunk_id"],
        "|",
        round(result["score"], 3)
    )


query = "Как удалить повторяющиеся элементы и оставить только уникальные значения?"

results = search_chunks(query, top_k=3)

for result in results:
    print(
        result["title"],
        "| чанк",
        result["chunk_id"],
        "|",
        round(result["score"], 3)
    )
Для каждого запроса система покажет три наиболее похожих чанка, их номера и коэффициент сходства. Если среди результатов появляются ожидаемые фрагменты документации, значит, поисковая часть прототипа работает на достаточном уровне.
Скриншот: Google Colab / Google / Skillbox Media
Шаг 3: устанавливаем LLM и тестируем RAG
Чтобы система не просто находила подходящие фрагменты, а формировала на их основе связный ответ, подключите языковую модель. Для примера используйте Qwen2.5-0.5B-Instruct:
from transformers import AutoTokenizer, AutoModelForCausalLM

model_name = "Qwen/Qwen2.5-0.5B-Instruct"

tokenizer = AutoTokenizer.from_pretrained(
    model_name
)

llm = AutoModelForCausalLM.from_pretrained(
    model_name,
    torch_dtype="auto",
    device_map="auto"
)

print("Qwen загружена.")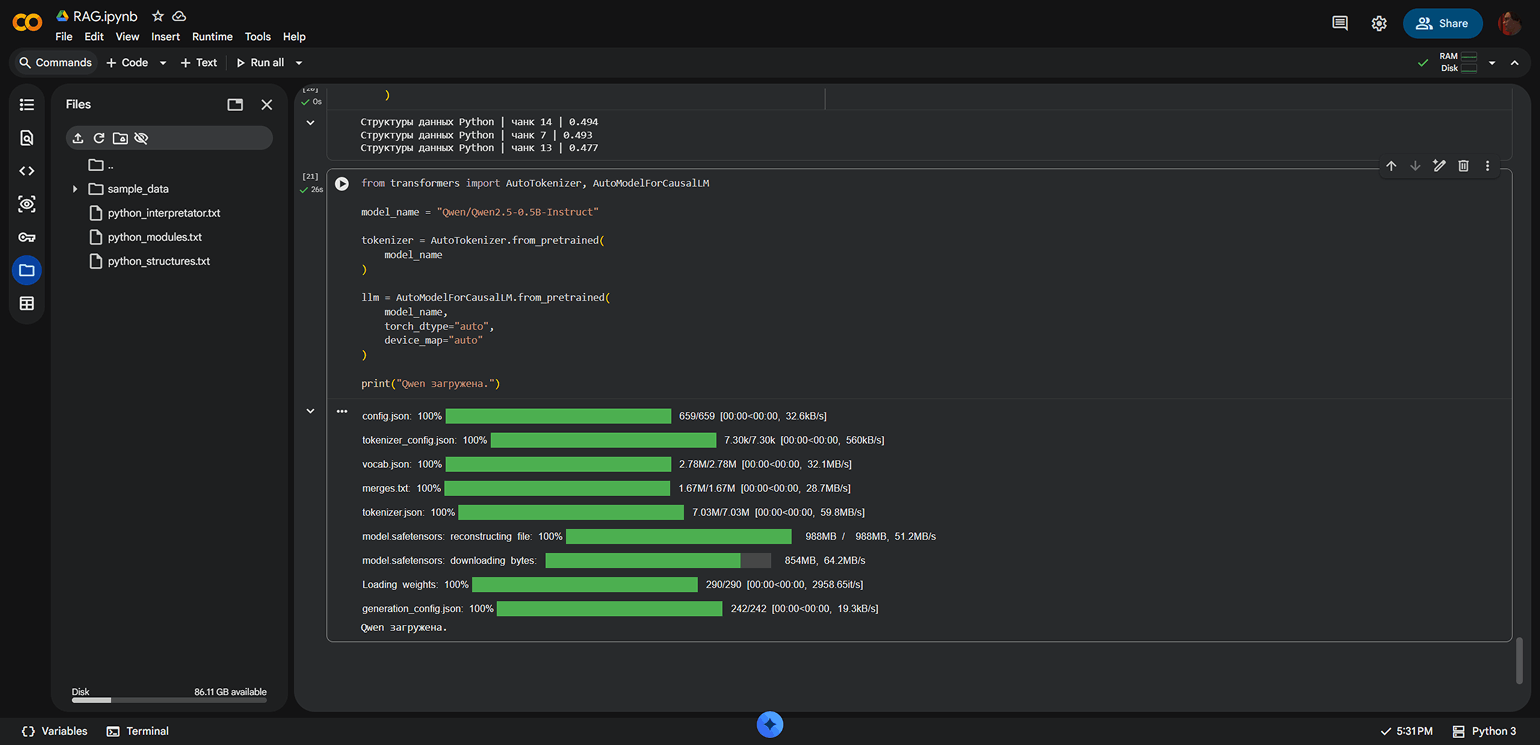
Скриншот: Google Colab / Google / Skillbox Media
Теперь объедините поиск по документам и генерацию ответа. Для этого создайте функцию, которая найдёт три наиболее подходящих чанка, передаст их модели как контекст и вернёт готовый ответ:
def ask_rag(query, top_k=3):

    # 1. Поиск подходящих чанков
    results = search_chunks(
        query,
        top_k=top_k
    )

    # 2. Сбор единого контекста из источников
    context_parts = []

    for result in results:

        context_parts.append(
            f"""
Источник: {result["title"]}
Фрагмент:
{result["text"]}
"""
        )

    context = "\n\n".join(context_parts)

    # 3. Создание инструкций для LLM
    messages = [
{
    "role": "system",
    "content":
        "Отвечай только на основании предоставленного контекста. "
        "Не добавляй сведения, которых нет в контексте. "
        "Если в контексте есть пример кода, используй именно его. "
        "Если информации недостаточно для точного ответа, скажи: "
        "'В предоставленных материалах недостаточно информации для ответа.'"
},
        {
            "role": "user",
            "content":
                f"""
Контекст:

{context}

Вопрос:

{query}
"""
        }
    ]

    # 4. Формирование запроса для Qwen
    text = tokenizer.apply_chat_template(
        messages,
        tokenize=False,
        add_generation_prompt=True
    )

    model_inputs = tokenizer(
        [text],
        return_tensors="pt"
    ).to(llm.device)

    # 5. Генерация ответа
    generated_ids = llm.generate(
        **model_inputs,
        max_new_tokens=250,
        do_sample=False
    )

    generated_ids = [
        output_ids[len(input_ids):]
        for input_ids, output_ids
        in zip(
            model_inputs.input_ids,
            generated_ids
        )
    ]

    answer = tokenizer.batch_decode(
        generated_ids,
        skip_special_tokens=True
    )[0]

    return answer, results
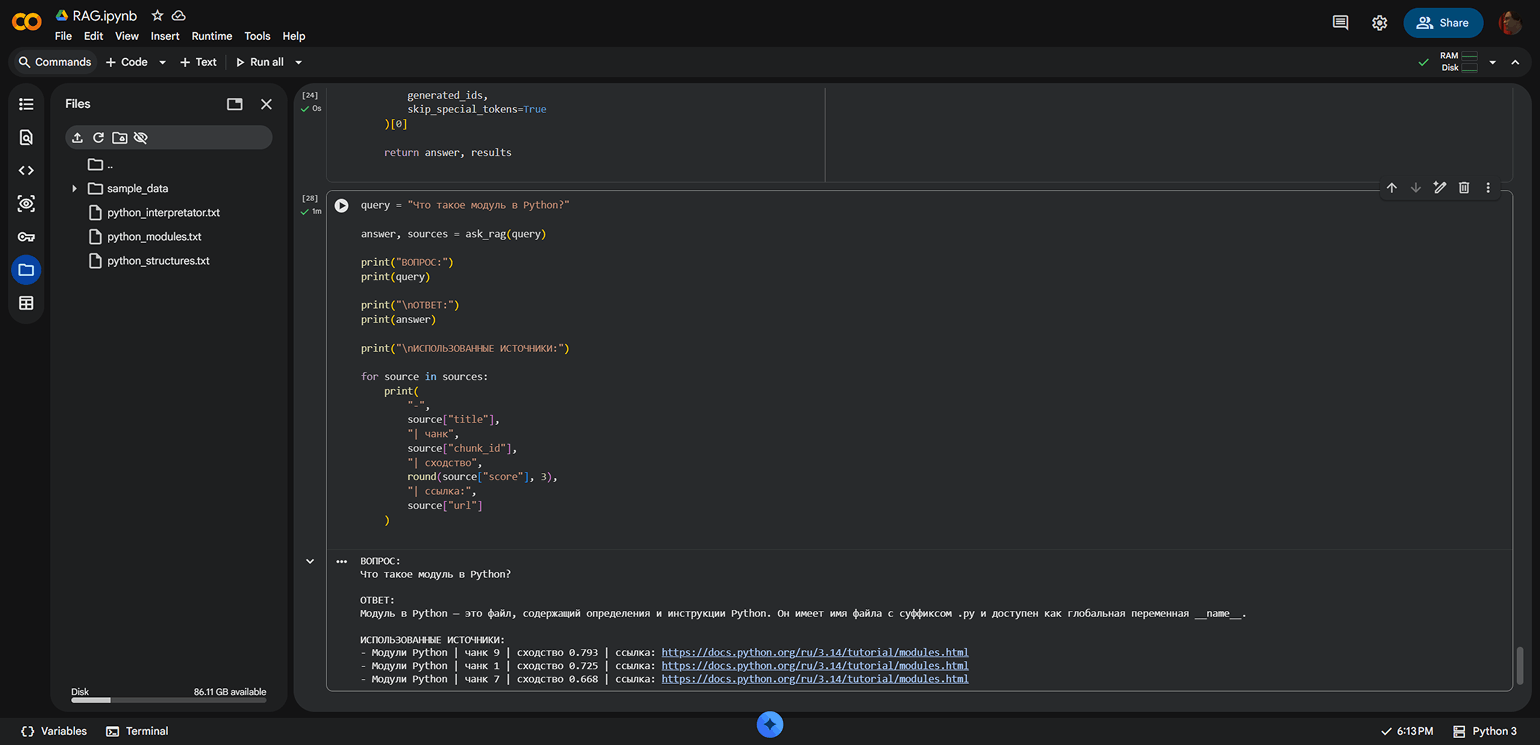
После этого протестируйте готовую RAG-систему:
query = "Что такое модуль в Python?"

answer, sources = ask_rag(query)

print("ВОПРОС:")
print(query)

print("\nОТВЕТ:")
print(answer)

print("\nИСПОЛЬЗОВАННЫЕ ИСТОЧНИКИ:")

for source in sources:
    print(
        "-",
        source["title"],
        "| чанк",
        source["chunk_id"],
        "| сходство",
        round(source["score"], 3),
        "| ссылка:",
        source["url"]
    )
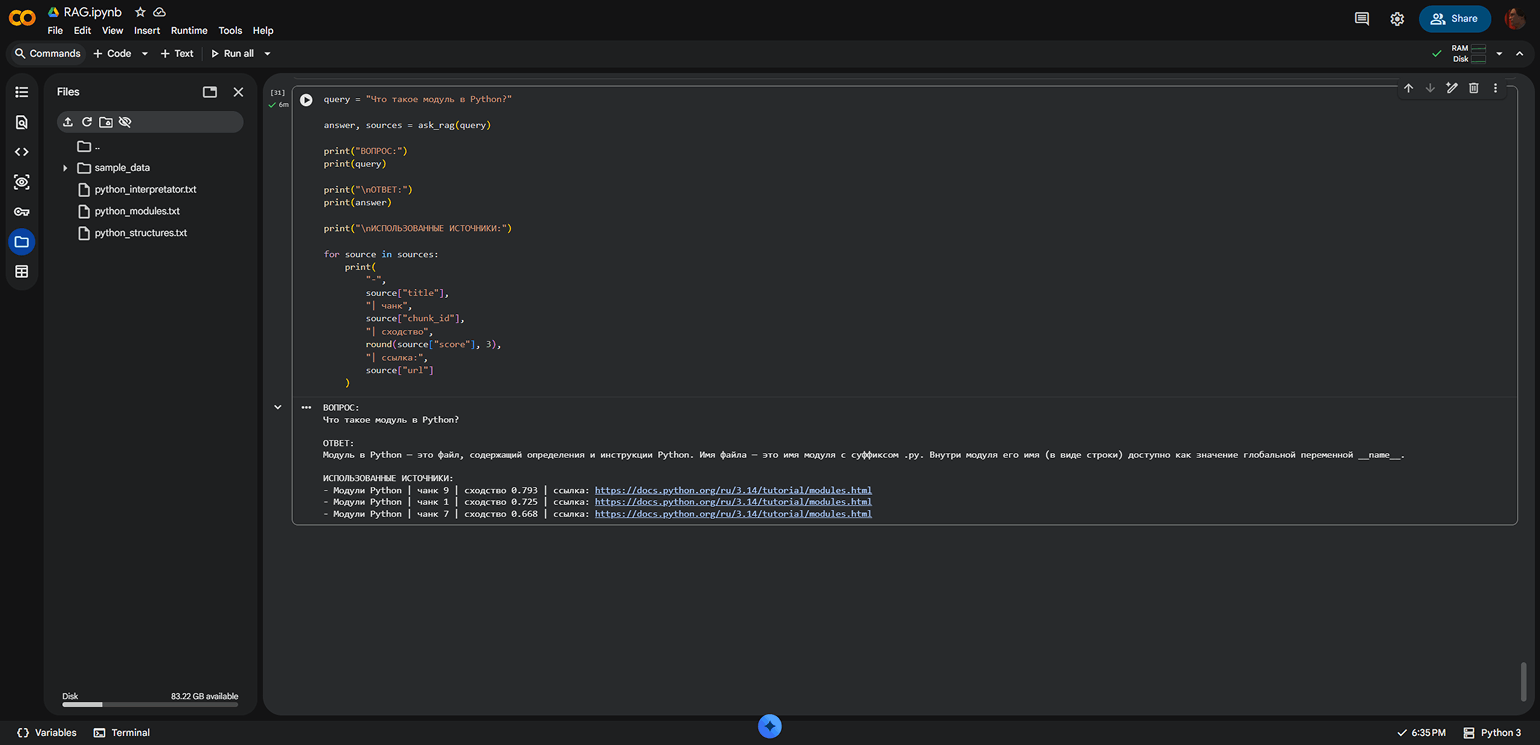
В результате вы получите сгенерированный ответ и список фрагментов, которые модель использовала как контекст.
На практике качество ответа зависит не только от поиска, но и от самой языковой модели. Например, Qwen2.5-0.5B-Instruct в нашем тесте неточно передала часть определения модуля из официальной документации Python.
В таком случае попробуйте продвинутые модели. В нашем эксперименте после замены Qwen2.5-0.5B-Instruct на Qwen2.5-1.5B-Instruct формулировка стала точнее. При этом более мощная модель сама по себе не гарантирует правильного ответа: результат также зависит от качества документов, чанкинга, поиска и инструкций для LLM.
Скриншот: Google Colab / Google / Skillbox Media
Скриншот: Google Colab / Google / Skillbox Media
Скриншот: Google Colab / Google / Skillbox Media
Как проверить качество работы RAG
Даже правильно собранная RAG-система не гарантирует точного ответа на каждый запрос. Ошибка может возникнуть на двух основных этапах: либо система находит неподходящие данные, либо языковая модель неправильно использует найденный контекст. Поэтому оценивать удобнее по частям.
Проверка поиска
Если система не нашла нужную информацию, проблема обычно находится в retrieval — этапе поиска подходящих фрагментов в базе знаний.
Причины могут быть разными: нужной информации вообще нет в документах, текст неудачно разбит на чанки, модель эмбеддингов плохо сопоставляет запрос с содержимым или в результаты попадает слишком много нерелевантных фрагментов. Иногда проблему создаёт и сам запрос — например, если он слишком общий.
Для проверки retrieval используют метрики, например Precision@K и Recall@K.
Здесь K — количество первых результатов поиска, которые оценивают. Например, если RAG передаёт модели три чанка, то K = 3.
Precision@3 показывает, сколько из этих трёх чанков действительно относятся к запросу. Если релевантны два из трёх, Precision@3 равен 2/3.
Recall@3 показывает, сколько нужных фрагментов система смогла найти среди всех релевантных фрагментов в базе. Эта метрика особенно важна, когда для полного ответа нужно извлечь информацию сразу из нескольких мест.
На практике сначала соберите небольшой набор тестовых вопросов и заранее отметьте, какие документы или чанки должны находиться для каждого из них. Затем проверьте, появляются ли они среди первых результатов поиска.
Проверка ответа модели
Если поиск работает правильно, но итоговый ответ содержит ошибки, проблема находится уже на этапе генерации.
Именно это произошло в нашем прототипе. Поиск находил нужные фрагменты документации Python, но Qwen2.5-0.5B-Instruct неточно передавала часть информации. После замены генеративной модели поисковый механизм остался прежним, а ответ стал точнее.
Поэтому полезно задавать для RAG два отдельных вопроса:
- Нашла ли RAG-система нужную информацию?
- Использовала ли LLM эту информацию корректно?
Для оценки сгенерированного ответа используют несколько показателей. Один из основных — faithfulness, или обоснованность ответа. Он показывает, подтверждаются ли утверждения модели найденным контекстом и не добавляет ли она сведения, которых в источниках нет.
Другой показатель — answer relevance, или релевантность ответа. Он помогает проверить, действительно ли модель отвечает на вопрос пользователя, а не уходит в сторону.
Для автоматизации таких проверок существуют инструменты Ragas, DeepEval и TruLens. Они могут использовать отдельную языковую модель как оценщика и сравнивать запрос, найденный контекст и итоговый ответ.
При этом ни одна отдельная метрика не показывает качество RAG-системы целиком. Например, ответ может быть очень релевантным вопросу, но содержать утверждения, которых нет в источниках. Или, наоборот, строго опираться на контекст, но не отвечать на вопрос пользователя.
Поэтому при тестировании RAG-системы проверяйте всю цепочку: запрос → найденные чанки → контекст для LLM → итоговый ответ. Такой подход помогает понять не только то, что система ошиблась, но и на каком именно этапе возникла проблема.
Что учить дальше
В этой статье вы собрали простой прототип RAG-системы без отдельного сервера, векторной базы и готовых RAG-фреймворков. Вы подготовили документы, разбили их на чанки, создали эмбеддинги, настроили поиск и подключили языковую модель для генерации ответов.
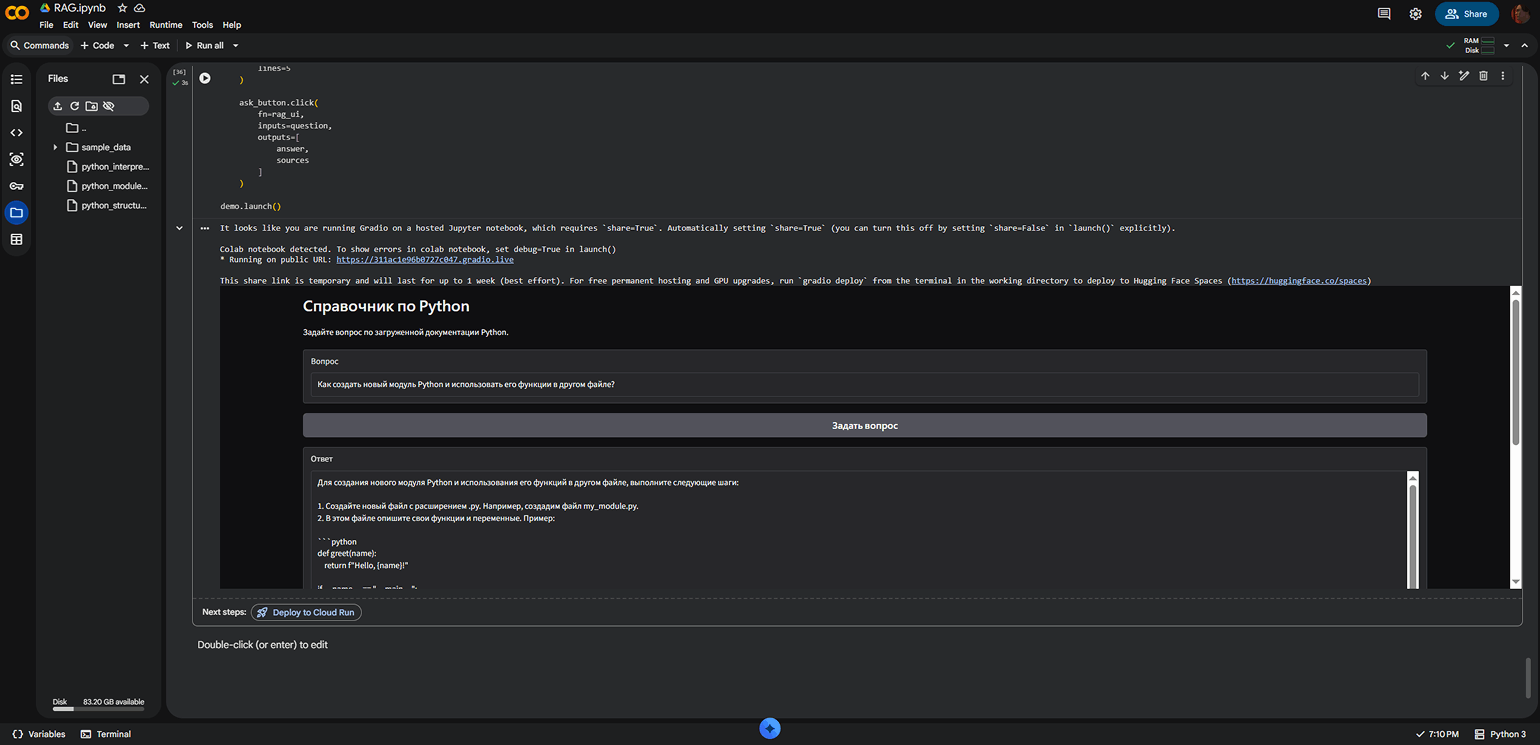
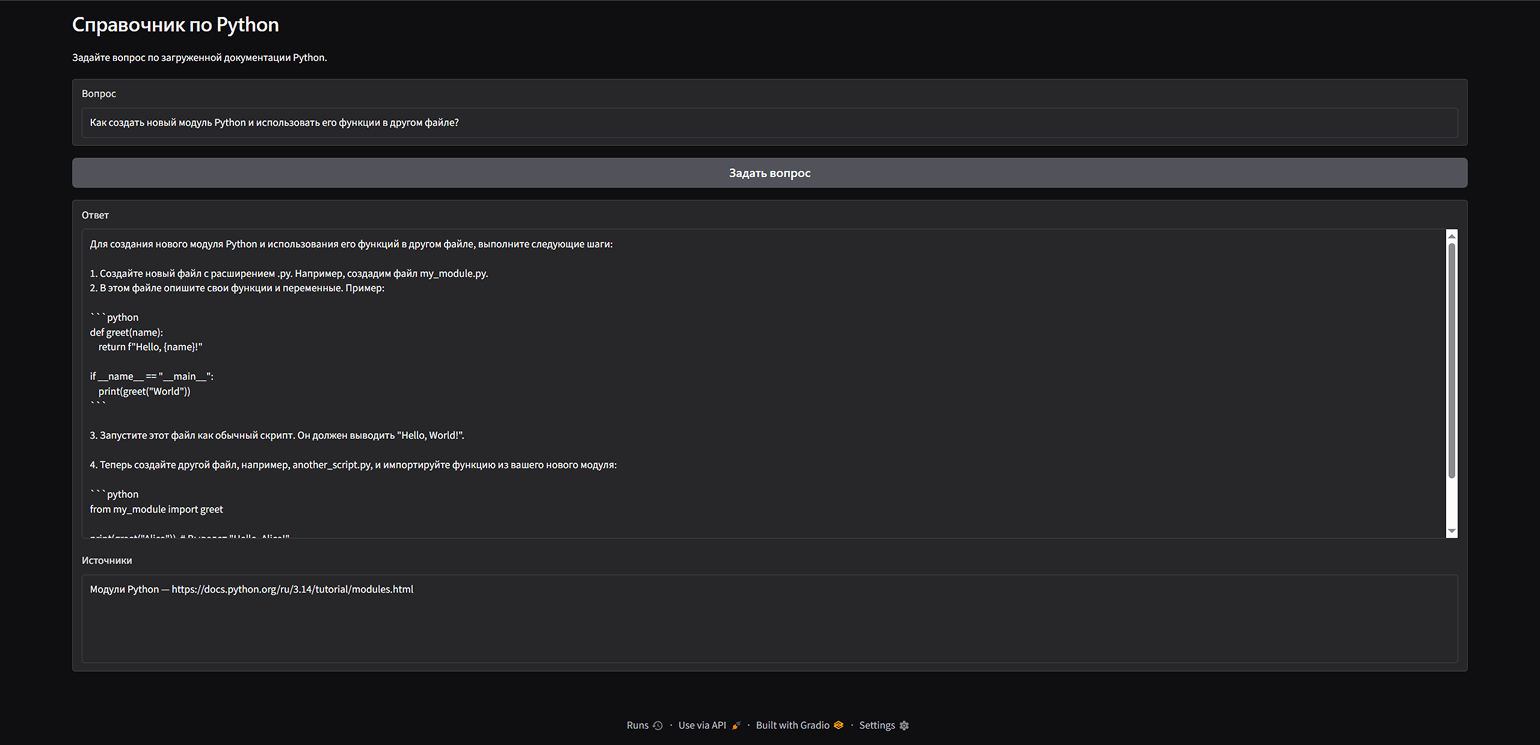
Теперь прототип можно развивать дальше. Например, добавьте веб-интерфейс, чтобы пользователь мог задавать вопросы без работы с кодом. В Google Colab для этого можно использовать библиотеку Gradio.
Если захотите приблизить прототип к рабочей системе, следующим шагом можно улучшить поиск, подключить векторную базу, автоматическое обновление документов, контроль доступа и мониторинг качества ответов.
Скриншот: Google Colab / Google / Skillbox Media
Скриншот: Skillbox Media
Больше интересного про код — в нашем телеграм-канале. Подписывайтесь!