Все
 Истории
 Дизайн
 Код
 Геймдев
 Бизнес
 Маркетинг
 Управление
 Кино
 Музыка
 Проектная фотография
 Развитие
 Деньги
 Здоровье
 Образование
 EdTech
 Корп. обучение
 Блог Skillbox
 Глоссарий
 Спецпроекты

Команда Kandinsky рассказала о новой модели для генерации видео со звуком
Нейросеть сможет создавать ролики по промпту продолжительностью до пяти секунд.
Команда Kandinsky опубликовала препринт с описанием Kandinsky 6.0 Video — семейства диффузионных моделей для генерации видео и аудио. Исследование появилось в цифровом хранилище arXiv 4 октября 2026 года по UTC. Авторы рассказали об архитектуре моделей, их обучении и о результатах сравнительной оценки.
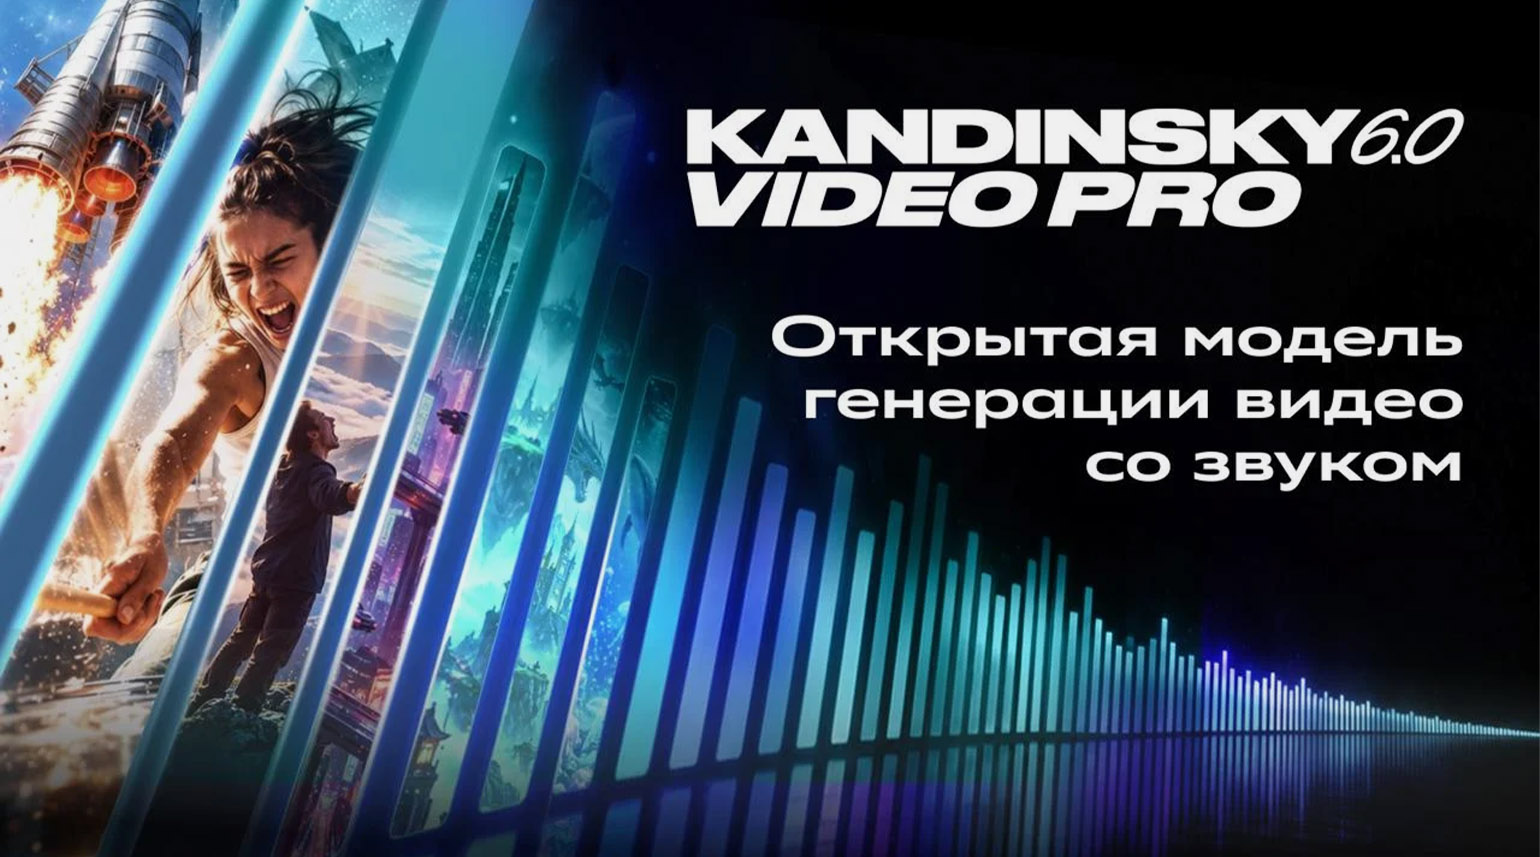
В семейство входят две версии: Lite с 3 миллиардами параметров и Pro с 29 миллиардами. Обе модели генерируют видео длительностью до пяти секунд и одновременно создают звуковую дорожку с частотой дискретизации 44 кГц. Система также умеет синхронизировать движения губ персонажа с речью.
В основе моделей лежит архитектура CrossDiT, которая объединяет видеопоток с аудиопотоком с помощью двунаправленного механизма внимания. Сначала модели проходят предварительное обучение, после чего авторы используют дообучение на размеченных данных, обучение с подкреплением и дистилляцию.
Базовая генерация выполняется в стандартном для моделей семейства разрешении. Для получения видео в формате 1920×1080 используется отдельная модель повышения разрешения.
Авторы также провели оценку моделей с участием людей и сообщили об улучшении версии Pro по сравнению с предыдущей моделью Kandinsky. При этом команда отмечает, что новая система пока уступает наиболее сильным закрытым решениям по визуальному качеству и общему качеству звука.
6 октября Kandinsky Lab сообщила об открытом выпуске модели. Команда планирует опубликовать исходный код, веса и интеграцию с библиотекой Diffusers под лицензией MIT.
В дальнейшем разработчики собираются увеличивать продолжительность генерируемых роликов и повышать их нативное разрешение.