Все
 Истории
 Дизайн
 Код
 Геймдев
 Бизнес
 Маркетинг
 Управление
 Кино
 Музыка
 Проектная фотография
 Развитие
 Здоровье
 Деньги
 Образование
 EdTech
 Корп. обучение
 Блог Skillbox
 Глоссарий
 Спецпроекты
 Профориентация

SRE-инженер: кто это, чем он занимается и как им стать
Разбираемся, кто помогает сервисам переживать сбои без серьёзных последствий и как это устроено.

Современные сервисы должны работать стабильно даже при высокой нагрузке, сбоях и постоянных обновлениях. Чем сложнее система, тем труднее поддерживать её надёжность вручную — поэтому компании используют подход SRE.
SRE-инженеры помогают сделать работу сервисов предсказуемой: следят за ключевыми показателями, настраивают мониторинг и автоматизацию, участвуют в разборе инцидентов и помогают командам выпускать изменения без лишнего риска.
В этой статье мы разберём, кто такой SRE-инженер, чем он занимается, какие инструменты и метрики использует, чем SRE отличается от DevOps и что нужно знать, чтобы начать работать в этой сфере.
Содержание
- Что такое SRE
- Кто такой SRE-инженер
- Чем пользуется специалист в работе
- Какие навыки нужны SRE-инженеру
- Сколько зарабатывает специалист
- Как стать SRE-инженером
Что такое SRE
SRE, или site reliability engineering, — это подход к эксплуатации IT-систем, при котором надёжность рассматривают как инженерную задачу. Команда не просто старается сделать сервис стабильным, а заранее определяет требования к его работе, измеряет показатели и принимает решения на основе данных.
Например, для сервиса можно задать допустимый уровень доступности, количество ошибок или время ответа. Если показатели начинают ухудшаться, команда понимает, что нужно временно снизить темп изменений и заняться надёжностью.
При этом SRE — это не только набор метрик. Важная часть подхода — автоматизация эксплуатации. Если инженеру приходится регулярно выполнять одно и то же действие вручную, такую работу стараются передать программе. Это может быть автоматический перезапуск сервиса, развёртывание инфраструктуры, обработка типовых инцидентов или масштабирование системы при росте нагрузки.
Подход SRE появился в Google в начале 2000-х годов. Команду эксплуатации в компании возглавил Бен Трейнор Слосс, который предложил применять к поддержке сервисов принципы разработки ПО. Вместо того чтобы увеличивать штат по мере роста нагрузки, инженеры должны были создавать инструменты и автоматизацию, которые позволяли обслуживать всё более крупные системы.
Позже Google систематизировал этот опыт в книгах Site Reliability Engineering и The Site Reliability Workbook. В них описаны основные практики SRE: SLI и SLO, бюджеты ошибок, мониторинг, работа с инцидентами и автоматизация.
Сегодня SRE используют далеко за пределами Google. Такой подход востребован в компаниях, где сервисы должны одновременно оставаться стабильными и часто обновляться: например, в банках, маркетплейсах, облачных платформах и крупных онлайн-сервисах.
Кто такой SRE-инженер
SRE-инженер, или инженер по доступности, отвечает за то, чтобы сервис оставался доступным, предсказуемым и устойчивым к сбоям. Для этого он работает сразу с несколькими уровнями системы: кодом, инфраструктурой, мониторингом и процессами эксплуатации.
В отличие от системного администратора, SRE обычно много автоматизирует и пишет код. В отличие от разработчика продукта, он занимается не пользовательскими функциями, а надёжностью самого сервиса.
Конкретный набор задач зависит от компании. В небольшой команде обязанности SRE могут выполнять DevOps-инженеры или разработчики. В крупных продуктах под SRE создают отдельные команды, которые отвечают за один или несколько критичных сервисов.
Чем занимается специалист
Большую часть работы SRE можно разделить на несколько направлений.
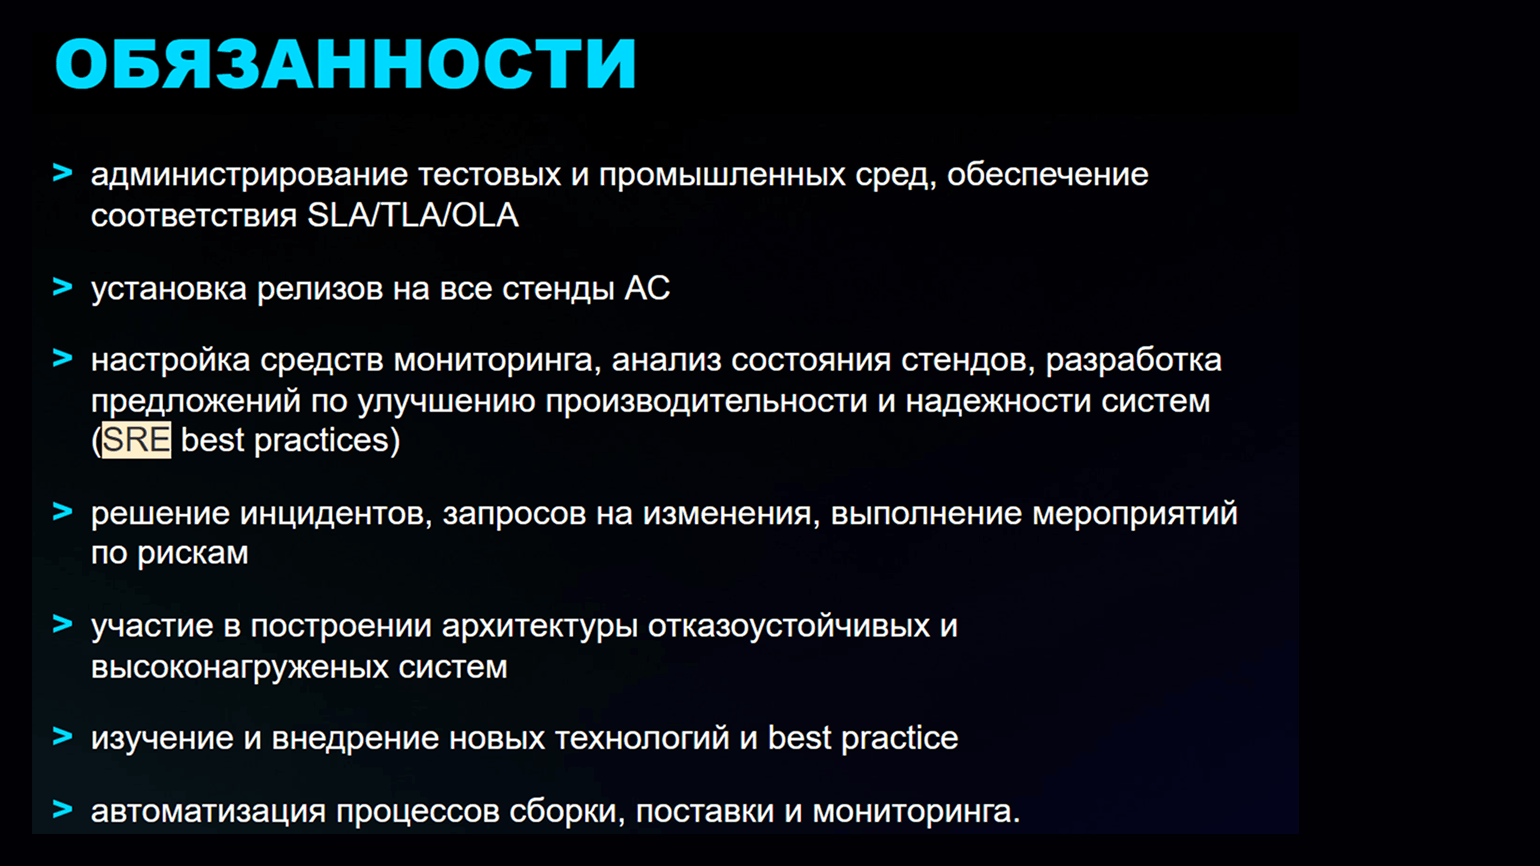
Мониторинг и обнаружение проблем. Инженер настраивает метрики, дашборды и алерты, чтобы команда узнавала о сбоях раньше пользователей. Он следит за доступностью сервиса, количеством ошибок, задержками и нагрузкой.
Работа с инцидентами. Если сервис перестал работать или начал заметно деградировать, SRE помогает определить причину, восстановить систему и сократить время простоя. В крупных командах для этого организуют дежурства — on-call.
Автоматизация. Повторяющиеся действия стараются переносить в код. Например, SRE может автоматизировать развёртывание инфраструктуры, масштабирование или восстановление компонентов после сбоя.
Повышение отказоустойчивости. Инженер помогает проектировать систему так, чтобы отказ одного компонента не приводил к падению всего сервиса. Для этого используют резервирование, репликацию, автоматические повторы запросов и другие механизмы.
Работа с релизами. SRE помогает выпускать обновления так, чтобы уменьшить риск серьёзного сбоя. Например, изменения можно сначала включить для небольшой части пользователей, а при проблемах быстро откатить.
Анализ надёжности. Инженер работает с SLI, SLO и бюджетом ошибок, анализирует инциденты и проводит постмортемы — структурированные разборы серьёзного сбоя или аварий, которые проводят после восстановления работы системы.
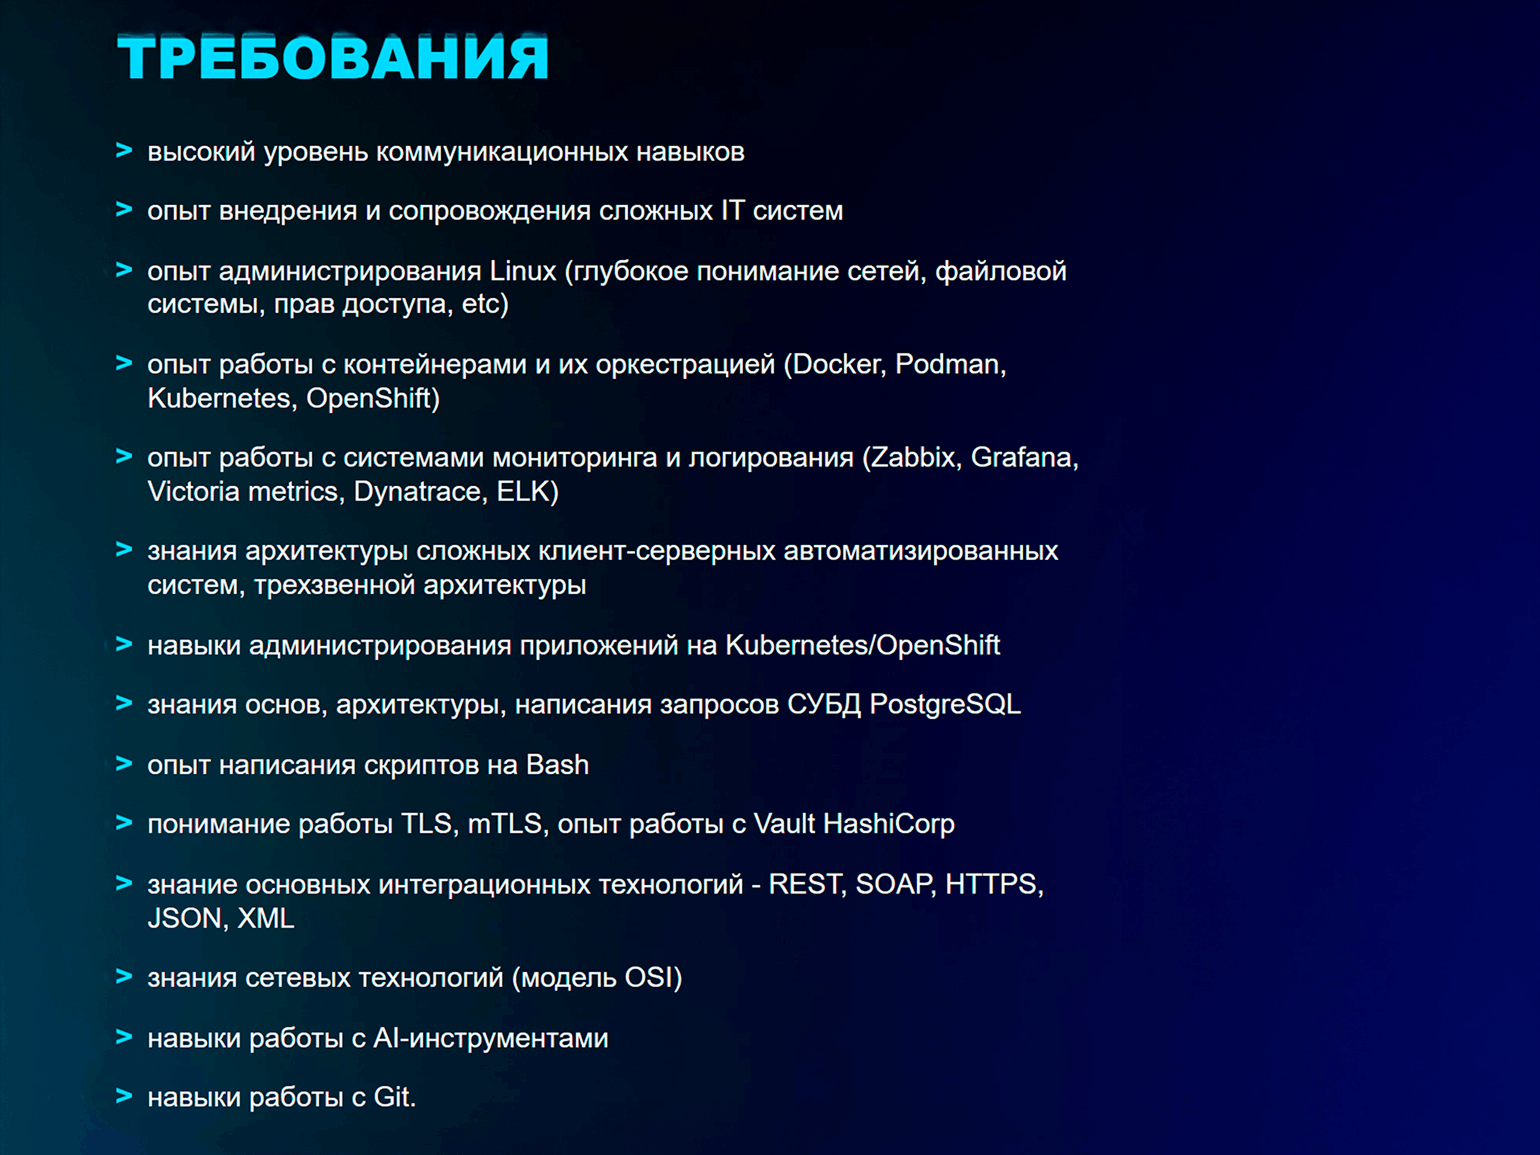
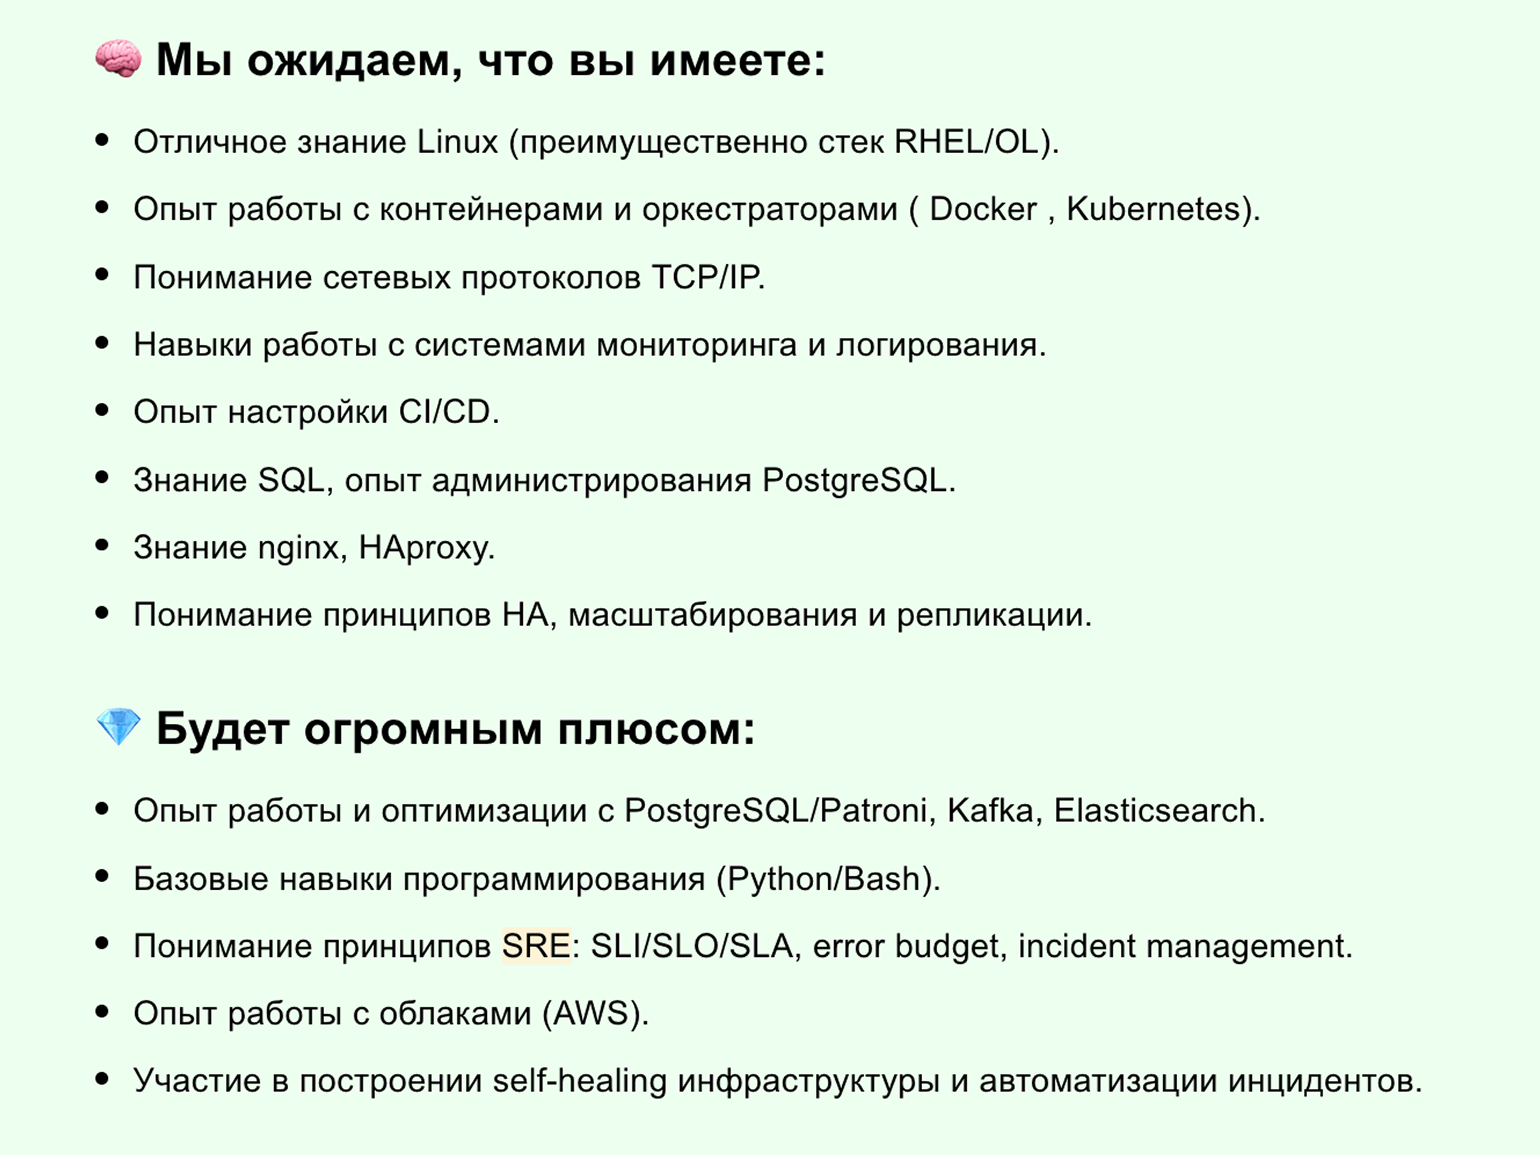
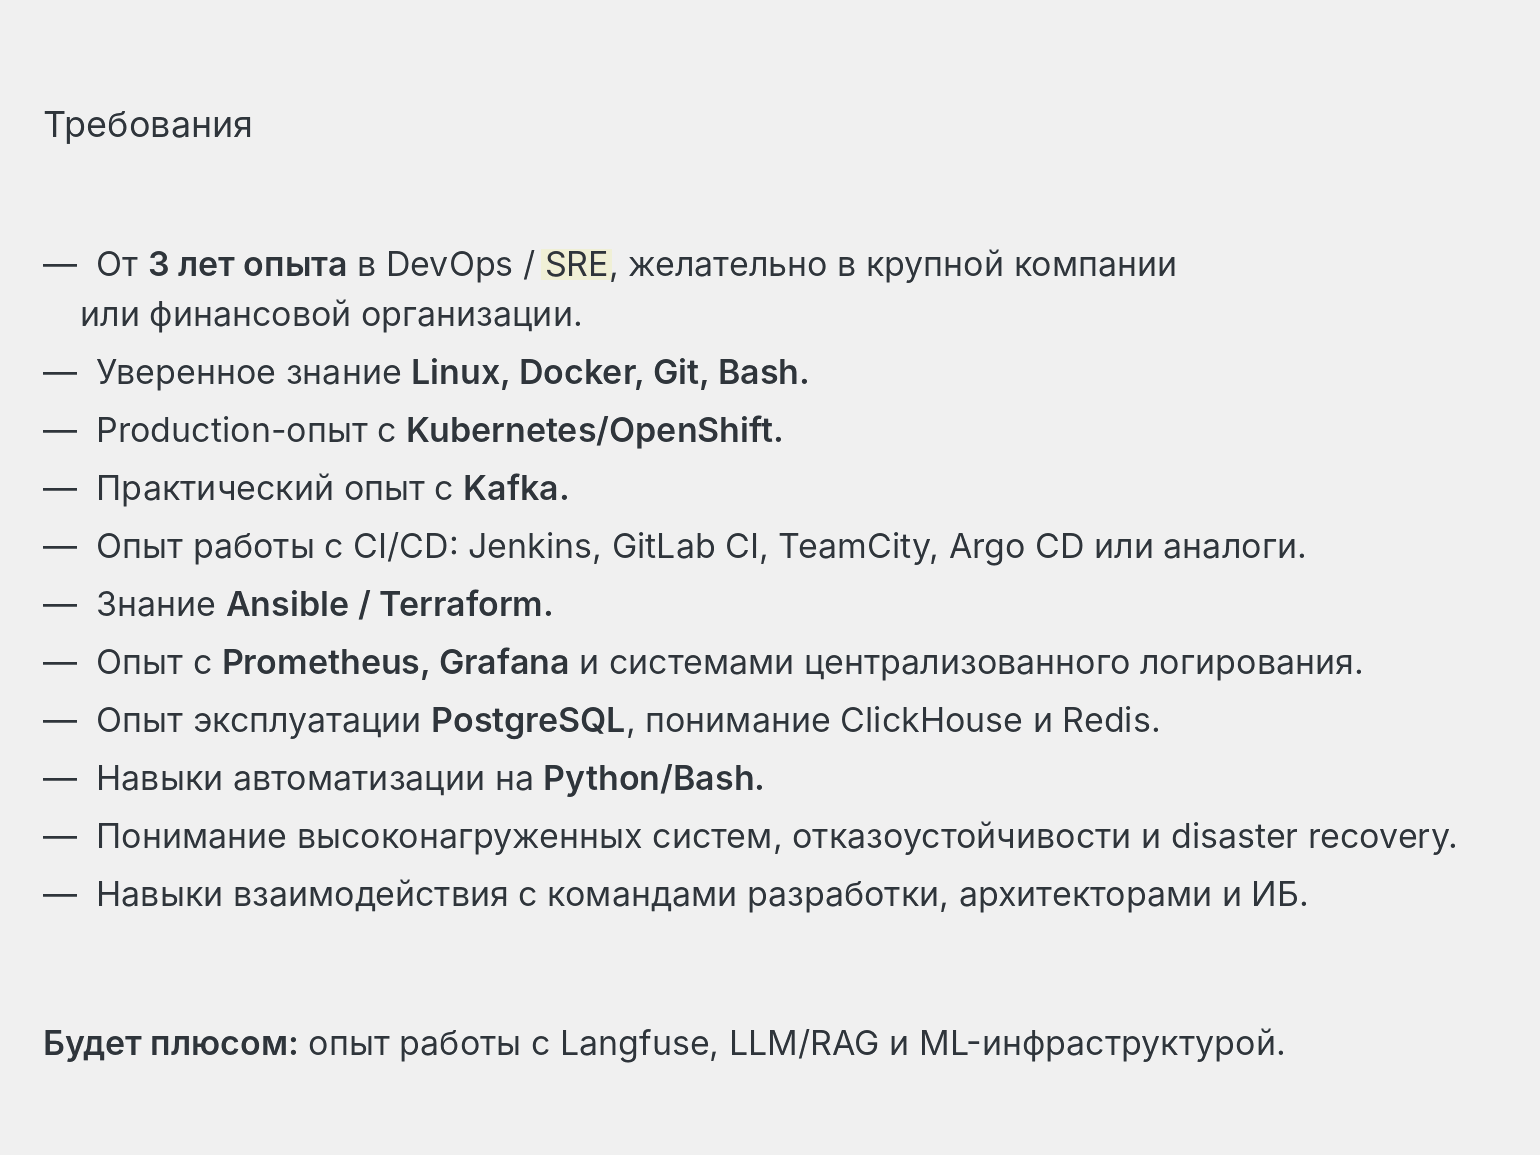
Скриншот: hh.ru / Skillbox Media
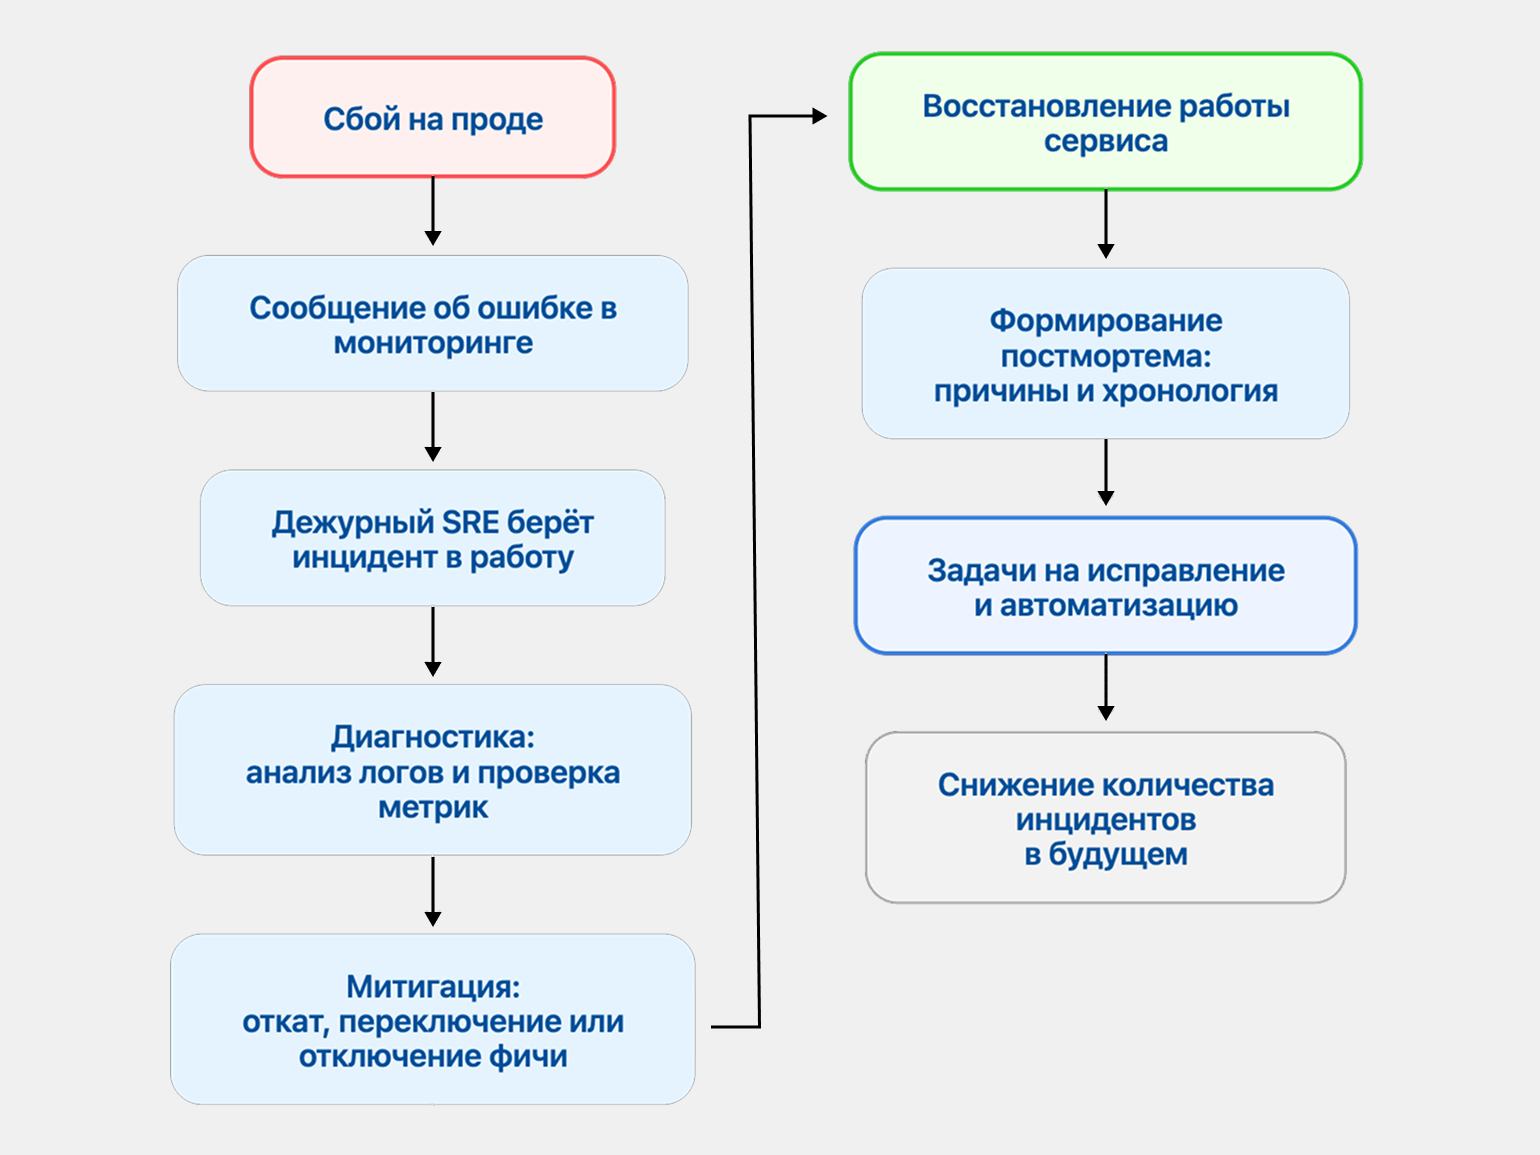
Роль SRE особенно заметна во время инцидентов. Сначала мониторинг фиксирует сбой и отправляет алерт, после чего дежурный SRE берёт инцидент в работу. Он анализирует логи и метрики, определяет причину проблемы и выбирает способ снизить её влияние: например, откатить релиз, переключить трафик или отключить проблемную функцию.
После восстановления сервиса работа не заканчивается. Команда разбирает причины и хронологию инцидента, формирует постмортем и ставит задачи на исправление и автоматизацию. Цель SRE — не только быстрее устранять сбои, но и снижать вероятность их повторения в будущем.
Изображение: Mermaid.ai / Skillbox Media
Чем SRE отличается от DevOps
SRE и DevOps часто используют одни и те же инструменты, поэтому граница между ними не всегда очевидна. Но задачи у этих подходов разные.
DevOps помогает разработке и эксплуатации работать как одной команде. Основной фокус — быстрее и стабильнее доставлять изменения: автоматизировать сборку, тестирование, деплой и работу с инфраструктурой.
SRE сосредоточен на надёжности сервиса. Команда задаёт SLI и SLO, следит за бюджетом ошибок, разбирает инциденты и решает, когда можно продолжать выпускать изменения, а когда нужно заняться стабильностью системы.
На практике роли часто пересекаются. И DevOps-, и SRE-инженеры могут работать с Kubernetes, CI/CD, Terraform, мониторингом и облаками. Разница обычно в приоритетах: DevOps больше отвечает за процессы доставки и инфраструктуру, SRE — за доступность, устойчивость и поведение сервиса под нагрузкой.
Поэтому в одной компании это могут быть две отдельные роли, а в другой — одна позиция с названием вроде «DevOps/SRE-инженер».
Чем пользуется SRE-инженер в работе
У SRE нет фиксированного набора инструментов: стек зависит от инфраструктуры, масштаба сервиса и процессов в команде. Но большинство решений можно разделить на несколько групп — мониторинг, диагностика, управление инфраструктурой, релизы и работа с инцидентами.
| Задача | Инструменты | Зачем нужны |
|---|---|---|
| Собирать метрики и строить дашборды | Prometheus, Grafana, Zabbix, Datadog | Следить за состоянием сервиса, замечать отклонения и настраивать алерты |
| Собирать и анализировать логи | Elastic Stack, Grafana Loki, ClickHouse | Искать причины ошибок и разбирать, что происходило во время сбоя |
| Отслеживать путь запроса | OpenTelemetry, Jaeger | Понимать, на каком этапе и в каком сервисе возникает задержка или ошибка |
| Запускать и оркестрировать сервисы | Docker, Kubernetes, Helm | Разворачивать приложения, масштабировать их и восстанавливать после сбоев |
| Управлять инфраструктурой как кодом | Terraform, OpenTofu, Ansible | Воспроизводимо создавать окружения и вносить изменения в инфраструктуру |
| Автоматизировать релизы | GitLab CI/CD, GitHub Actions, Jenkins, Argo CD | Выкатывать изменения, проверять их и быстро откатываться при проблемах |
| Управлять дежурствами и инцидентами | PagerDuty, Opsgenie, Grafana OnCall | Доставлять алерты нужному специалисту и координировать реакцию команды |
| Проверять устойчивость системы | Chaos Mesh, Gremlin, k6 | Имитировать сбои и нагрузку, чтобы находить слабые места до реальных аварий |
Какие навыки нужны SRE-инженеру
Специалисты редко становятся SRE с нуля. Обычно в эту роль приходят из бэкенд-разработки, DevOps, системного администрирования или эксплуатации. Причина проста: SRE-инженер должен одновременно понимать, как устроены IT-продукты, инфраструктура и процессы доставки кода и что происходит, когда на одном из этих уровней возникают проблемы.
Базовый набор навыков обычно включает несколько направлений.
Системы и сети
SRE-инженер должен уверенно работать с Linux, понимать процессы в операционной системе, файловую систему, права доступа, systemd и уметь диагностировать проблемы через командную строку.
Не менее важны сети: DNS, HTTP и HTTPS, TCP/IP, TLS, прокси и балансировка нагрузки. Эти знания нужны, чтобы разбираться, почему сервис стал медленно отвечать, теряет соединения или недоступен для части пользователей.
Программирование и автоматизация
SRE-инженер много автоматизирует, поэтому ему нужен хотя бы один язык программирования — чаще Python или Go. Bash используют для небольших скриптов и работы с окружением.
Читайте также:
На практике специалист пишет внутренние инструменты, автоматизирует рутинные операции, настраивает проверки и убирает процессы, которые раньше приходилось выполнять вручную.
Инфраструктура и доставка приложений
Инженер по эксплуатации должен понимать, как приложение попадает в продакшен и где оно работает. Обычно специалисты используют Docker, Kubernetes, Helm, Terraform или OpenTofu, Ansible, а также системы CI/CD.
Также нужно понимать весь жизненный цикл приложения: как его развернуть, обновить, масштабировать и откатить при проблемах.
Диагностика проблем
Одна из ключевых задач SRE — быстро замечать проблемы и находить их причины. Для этого используют метрики, логи, трассировку и алерты.
Инженер должен уметь работать с Prometheus, Grafana, OpenTelemetry или похожими инструментами, а главное — понимать, какие сигналы действительно отражают состояние сервиса.
Распределённые системы и надёжность
SRE работает с системами, где сбой одного компонента может повлиять на другие сервисы. Поэтому важно понимать репликацию, очереди, таймауты, ретраи, балансировку и каскадные отказы. На практике инженер может работать с Kafka или RabbitMQ, Redis, PostgreSQL, Nginx другими компонентами распределённой инфраструктуры.
SRE-практики
Наконец, инженер должен знать сами практики SRE: SLI, SLO, бюджет ошибок, on-call, управление инцидентами и постмортемы.
Эти навыки помогают управлять надёжностью IT-сервиса: понимать, какой уровень стабильности нужен продукту, когда можно выпускать изменения и где инфраструктура может перестать справляться с ростом нагрузки.
На практике от SRE редко ждут одинаково глубоких знаний во всех этих областях. Обычно у инженера есть сильная база в инфраструктуре или разработке, а остальные компетенции он наращивает по мере работы с конкретными системами.
Сколько зарабатывает SRE-инженер
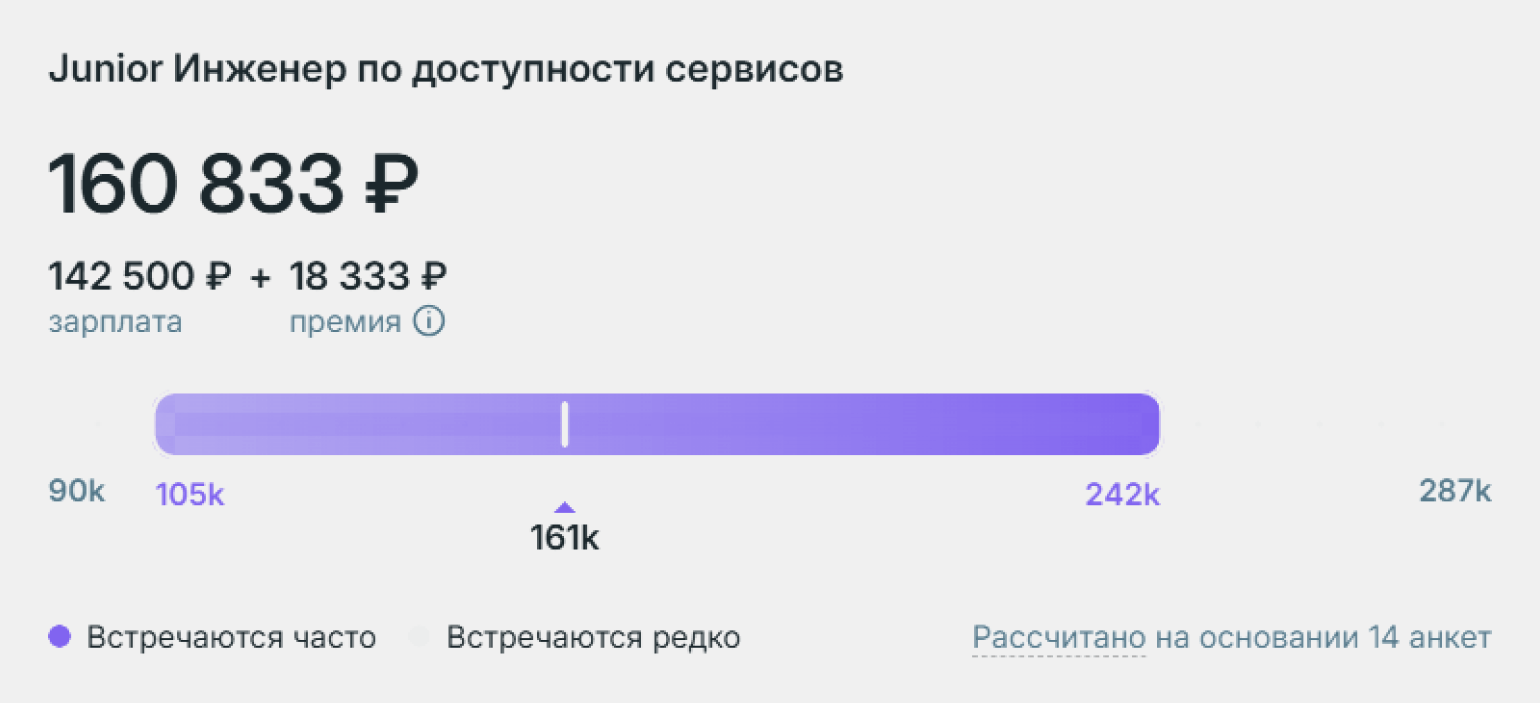
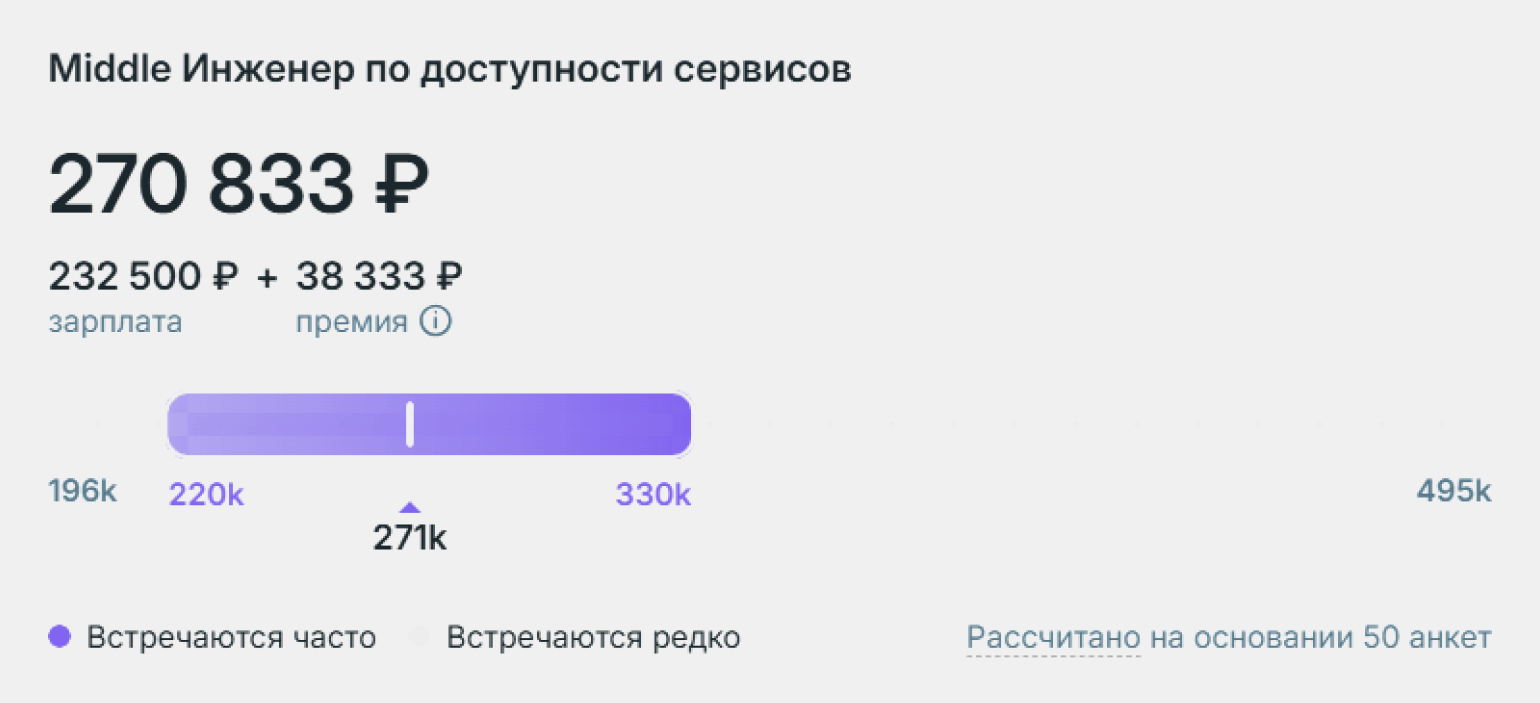
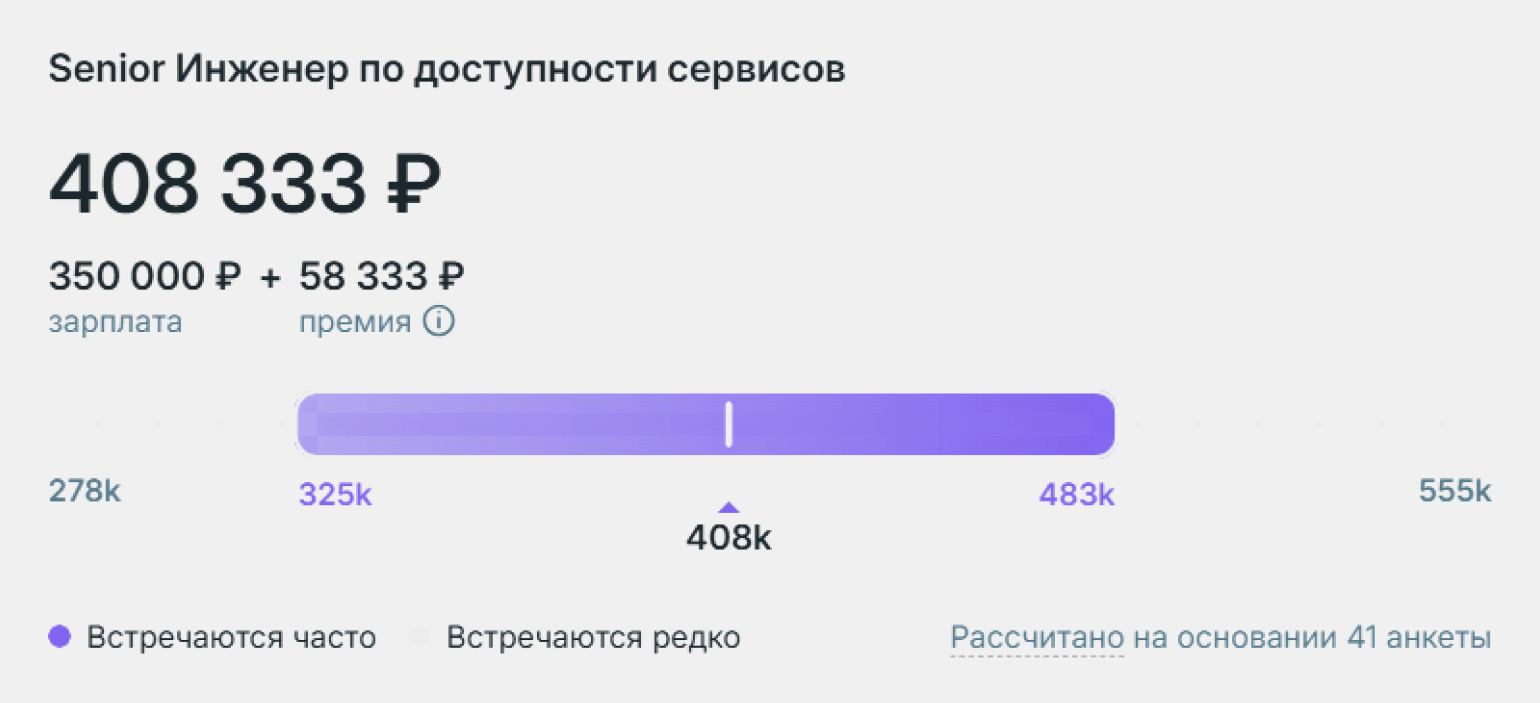
Ориентироваться в зарплатах SRE-инженеров можно по данным зарплатного калькулятора «Хабр Карьеры». Сервис регулярно обновляет статистику и позволяет сравнивать доходы специалистов разного уровня.
На момент подготовки статьи, в 2026 году, медианная зарплата SRE-инженера составляет около 316 000 рублей. Доход заметно зависит от опыта: специалисты уровня junior получают в среднем 161 000 рублей, middle — около 271 000 рублей, senior — около 408 000 рублей.
На зарплату также влияют масштаб инфраструктуры, стек технологий и уровень ответственности. Обычно выше оплачиваются позиции, где инженер работает с высоконагруженными системами, Kubernetes, облачной инфраструктурой и отвечает за критичные для бизнеса сервисы.
Скриншот: «Хабр Карьера» / Skillbox Media
Скриншот: «Хабр Карьера» / Skillbox Media
Скриншот: «Хабр Карьера» / Skillbox Media
За рубежом доходы значительно выше. В США медианная зарплата специалистов составляет около 159 тысяч долларов в год. При этом диапазон тоже широкий — примерно от 96 тысяч долларов до 264 тысяч долларов в зависимости от компании, штата и специализации.
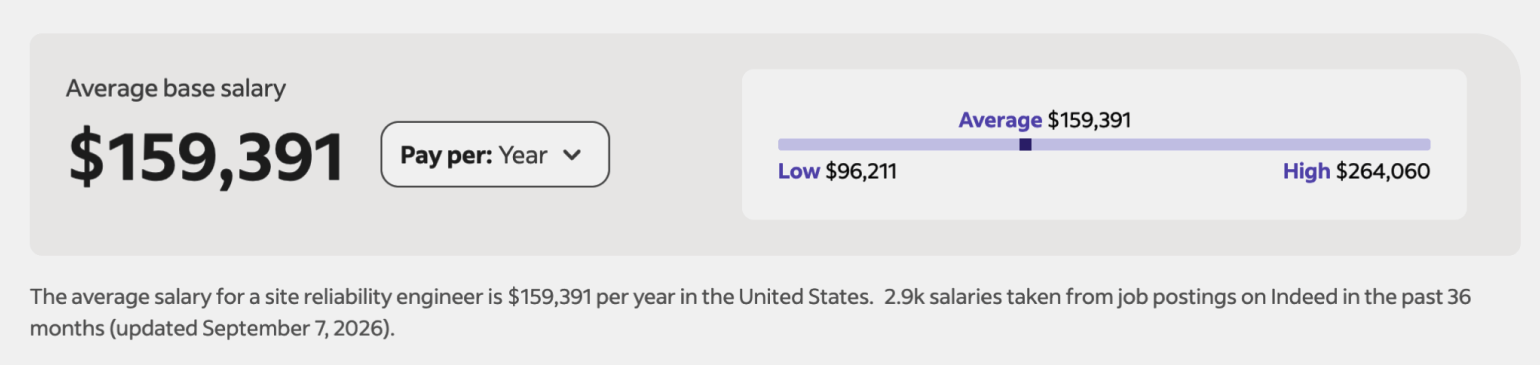
Скриншот: Indeed / Skillbox Media
Как стать SRE-инженером
Войти в SRE с нуля сложнее, чем во многие другие IT-профессии. Но путь можно выстроить постепенно — от базовой инфраструктуры к практикам надёжности.
Шаг 1: изучите вакансии. Посмотрите требования к SRE-инженерам на hh.ru и других площадках. Обратите внимание, какие технологии встречаются чаще всего: Linux, Kubernetes, Terraform, Prometheus, Grafana, облачные платформы. Так будет проще понять, какие навыки нужны именно на рынке.
Шаг 2: укрепите базу. Разберитесь в Linux, сетях, процессах, файловой системе, DNS, HTTP, TCP/IP и балансировке нагрузки. Без этой основы сложно диагностировать реальные сбои.
Ориентироваться в темах можно по roadmap.sh. Там есть дорожная карта по DevOps и инфраструктуре: Linux, сети, контейнеры, CI/CD, облака, мониторинг и Infrastructure as Code.
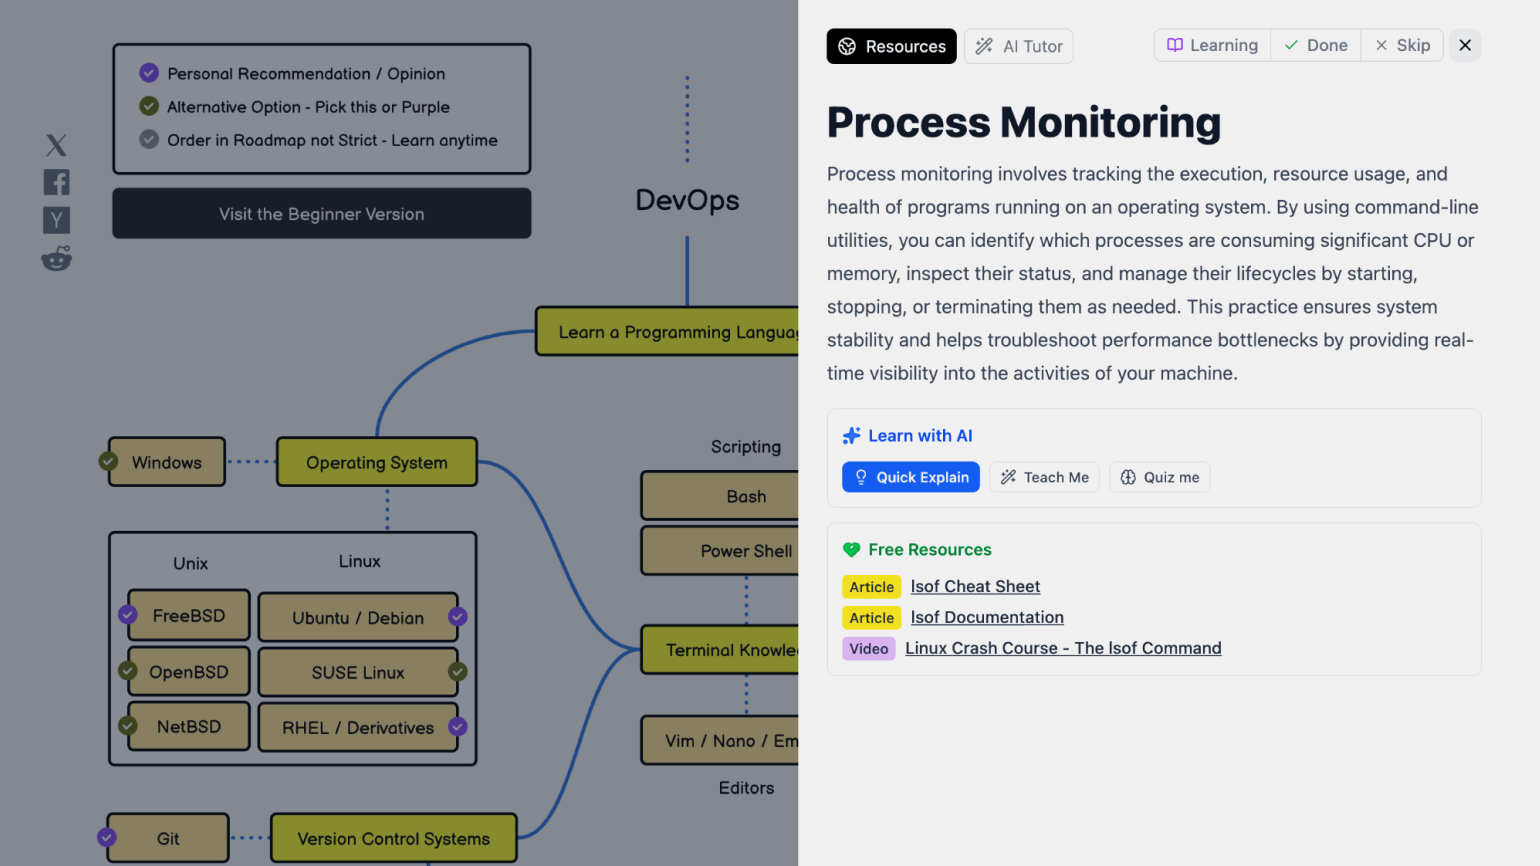
Скриншот: roadmap.sh / Skillbox Media
Шаг 3: изучите инфраструктурные инструменты. Освойте Docker, Kubernetes, CI/CD и Infrastructure as Code. На этом этапе важно понять весь путь приложения: как его развернуть, обновить, масштабировать и откатить.
Шаг 4: научитесь наблюдать за IT-системой. Настройте для любого проекта метрики, логи, трассировку и алерты. Попробуйте собрать простой стенд с Prometheus и Grafana, а затем намеренно сломать сервис и найти причину проблемы по данным мониторинга.
Шаг 5: разберитесь в SRE-практиках. Изучите SLI, SLO, error budget, on-call, incident management и постмортемы. Эти знания отличают SRE от просто инфраструктурного инженера.
Шаг 6: соберите учебный проект. Например, разверните небольшой сервис в Kubernetes, настройте мониторинг, автоматический деплой, алерты и откат при неудачном релизе. Затем смоделируйте сбой и проведите постмортем.
Шаг 7: откликайтесь на вакансии. Необязательно ждать, пока вы освоите весь стек, встречающийся в требованиях для трудоустройства. Если есть хорошая база в Linux, сетях, автоматизации и инфраструктуре, можно начинать откликаться на джуниор-позиции с SRE-задачами. Собеседования быстро покажут, какие пробелы стоит закрыть.
Больше интересного про код — в нашем телеграм-канале. Подписывайтесь!